L’architecture de l’édition scientifique numérique : identifiants pérennes, métadonnées, plateformes de diffusion, libre accès et principes FAIR. L’exemple de Carnets botaniques
Title
The architecture of digital scholarly publishing: persistent identifiers, metadata, dissemination platforms, open access, and the FAIR principles. The case of Carnets botaniques
Résumé
L’édition scientifique numérique repose sur une architecture de dispositifs complémentaires : identifiants pérennes, agences d’enregistrement, métadonnées structurées, plateformes de découverte et de diffusion, licences de réutilisation et mécanismes de préservation. Cet article propose une synthèse historique et technique de leurs fonctions et de leurs articulations, en accordant une attention particulière au DOI, au système Handle et aux agences Crossref et DataCite. Il distingue les rôles des identifiants DOI, ORCID, ROR et ISSN, les services de découverte (notamment OpenAlex, Google Scholar et ResearchGate), les politiques de libre accès et les licences Creative Commons. Les principes FAIR — facilité de découverte, accessibilité, interopérabilité et réutilisabilité — offrent un cadre d’analyse transversal, sans être assimilables au seul libre accès. L’expérience de Carnets botaniques, dont 314 DOI historiques ont été transférés de DataCite à Crossref en conservant leurs chaînes d’identification, illustre les possibilités et les exigences d’une gestion éditoriale durable. Une figure de synthèse présente les principaux acteurs et leurs relations, sans présumer de flux directs entre tous les services.
Abstract
Digital scholarly publishing is based on an architecture of complementary systems: persistent identifiers, registration agencies, structured metadata, discovery and sharing platforms, reuse licences, and preservation mechanisms. This article reviews their history, technical foundations, and interconnections, focusing on DOIs, the Handle system, Crossref, and DataCite. It distinguishes DOI, ORCID, ROR, and ISSN identifiers, discovery services such as OpenAlex, Google Scholar, and ResearchGate, open-access policies, and Creative Commons licences. The FAIR principles —Findable, Accessible, Interoperable, Reusable — provide a cross-cutting framework and should not be conflated with open access alone. The case of Carnets botaniques, whose 314 historical DOI records were transferred from DataCite to Crossref without changing their identifiers, illustrates the practical challenges of sustainable journal publishing. An overview figure maps the main components of this ecosystem without implying that all services exchange data directly.
1. Introduction : comprendre l’architecture de l’édition scientifique numérique
L’identification documentaire a toujours cherché à résoudre une difficulté fondamentale : reconnaître une publication de manière non équivoque, indépendamment de son support, de son lieu de conservation ou de ses modalités de diffusion.
Dans l’univers imprimé, les numéros normalisés des publications en série et des livres ont contribué à stabiliser les échanges bibliographiques. Avec le développement du numérique, cette question a pris une dimension nouvelle : l’adresse informatique d’un document ne constitue pas nécessairement son identité. En effet, une page peut être déplacée lors de la refonte d’un site, un nom de domaine peut changer et une plateforme peut disparaître, alors que les références bibliographiques doivent demeurer intelligibles et exploitables pendant plusieurs décennies (Paskin, 2002 ; Klein et al., 2014).
Cette distinction entre identité et localisation est essentielle à la continuité de la communication scientifique. Elle conditionne la possibilité de retrouver les sources, de vérifier les résultats publiés, de suivre les relations entre travaux et de consulter les publications anciennes. Les études de Klein et al. (2014) et de Jones et al. (2016) ont notamment mis en évidence un phénomène que les anglophones appellent « reference rot » (« pourrissement des références » en français), qui associe disparition de liens et modification des contenus auxquels ils renvoient. Les identifiants pérennes, au premier rang desquels le DOI (Digital Object Identifier), contribuent à limiter cette instabilité, sans garantir à eux seuls ni l’accessibilité ni la conservation des documents.
La pérennité de l’information scientifique repose en réalité sur un ensemble de dispositifs complémentaires. Aux identifiants des publications (DOI) s’ajoutent ceux des auteurs (ORCID), des institutions (ROR) et des revues, les agences d’enregistrement, les métadonnées transmises via des fichiers XML, les plateformes de diffusion, les politiques de libre accès, les licences de réutilisation et les mécanismes de préservation numérique. Chacun a son rôle propre, mais leur articulation détermine la capacité des publications à être retrouvées, citées, reliées à d’autres travaux et réutilisées. Les principes FAIR (Findable, Accessible, Interoperable, Reusable) fournissent un cadre pour analyser ces différentes dimensions.
Le présent article propose une synthèse historique, technique et fonctionnelle de cet écosystème, destinée notamment aux responsables de revues scientifiques indépendantes. Il examine le fonctionnement du DOI et du système Handle, le rôle des agences Crossref et DataCite, la structuration des métadonnées et leurs relations avec les services de découverte, ainsi que les conditions juridiques et techniques de l’accès et de la réutilisation des publications. L’expérience de Carnets botaniques, revue de la Société botanique d’Occitanie, sert de fil conducteur à cette analyse. Le réenregistrement sans changement auprès de Crossref de ses 314 DOI historiques, initialement gérés par DataCite, permet d’illustrer concrètement les enjeux d’une gestion éditoriale durable.
2. Définition, structure et résolution des DOI
2.1. Historique
L’histoire du DOI ne commence pas avec les plateformes actuelles de revues. Elle s’inscrit dans les réflexions conduites depuis les années 1990 sur la représentation des objets numériques et leur identification indépendamment de leur localisation. Les travaux fondateurs sont ceux publiés par Kahn et Wilensky, repris dans leur publication de 2006, qui décrivent des objets dotés d’identifiants, susceptibles d’être gérés dans une architecture numérique complexe.
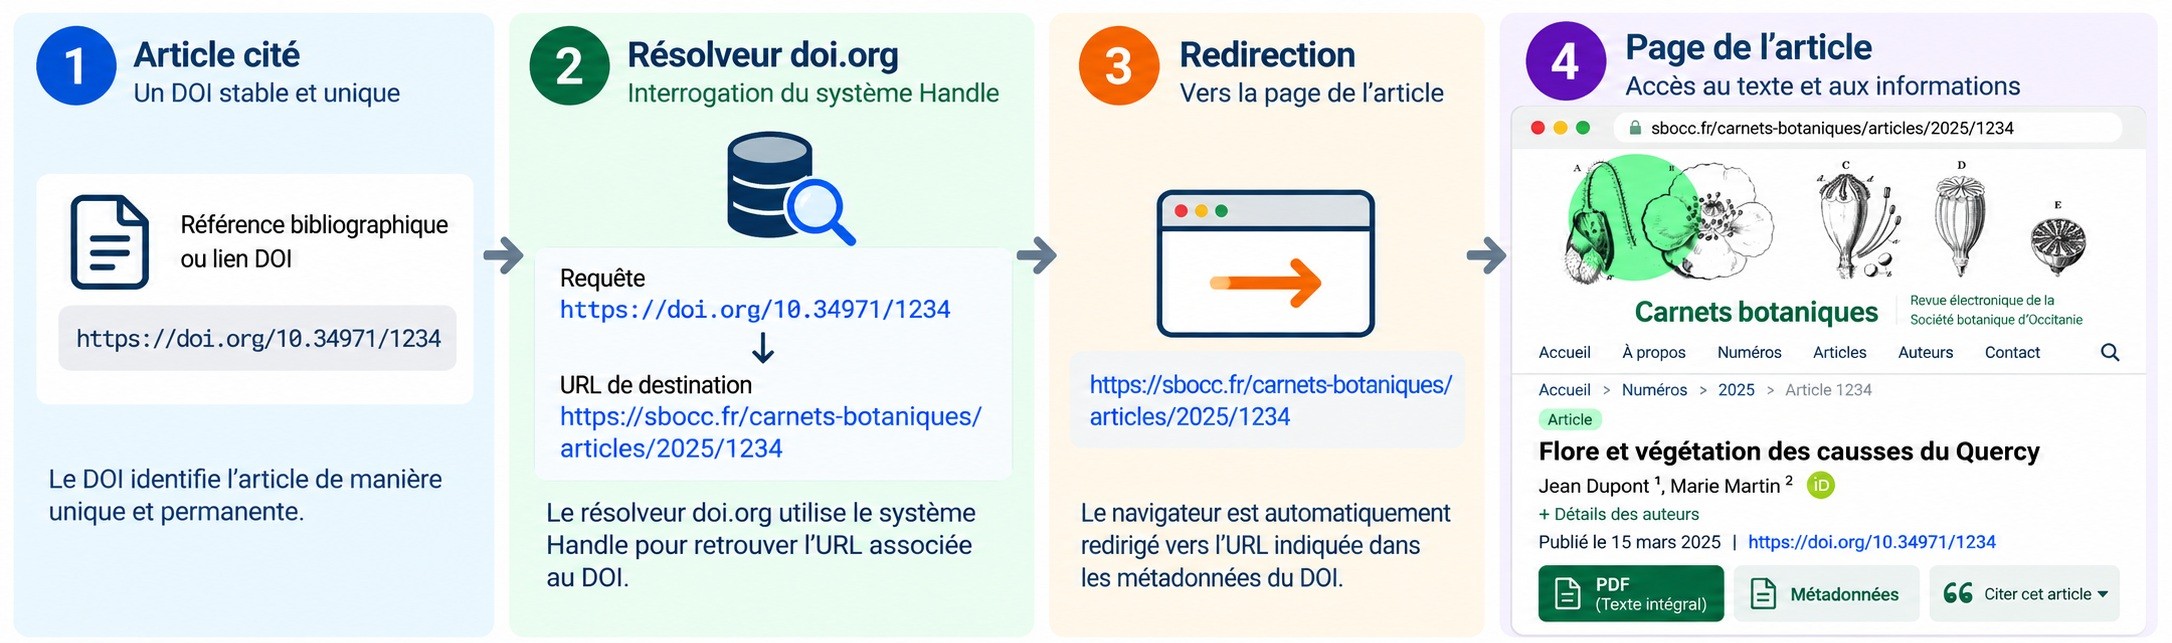
Cette réflexion accompagne le développement du système « Handle », sur lequel s’appuie le mécanisme de résolution utilisé par les DOI. Il constitue l’infrastructure technique sur laquelle repose notamment le DOI. Il peut également gérer d’autres identifiants pérennes. La résolution de ces identifiants s’effectue par l’intermédiaire de services spécialisés : doi.org pour les DOI et, par exemple, hdl.handle.net pour les identifiants Handle génériques. En résumé :
- le système Handle est une infrastructure distribuée de gestion et de résolution d’identifiants persistants, conçue pour dissocier le nom d’un objet numérique de son emplacement sur un serveur. Un handle est une chaîne enregistrée dans ce système ; les DOI en constituent une application normalisée, gouvernée par la DOI Foundation ;
- le résolveur DOI est un service informatique, accessible à l’adresse https://doi.org, qui permet de retrouver la localisation actuelle d’une ressource à partir de son identifiant DOI. Il s’appuie sur le système Handle pour associer le DOI à une adresse URL et redirige automatiquement l’utilisateur vers celle-ci, de façon parfaitement invisible pour lui.
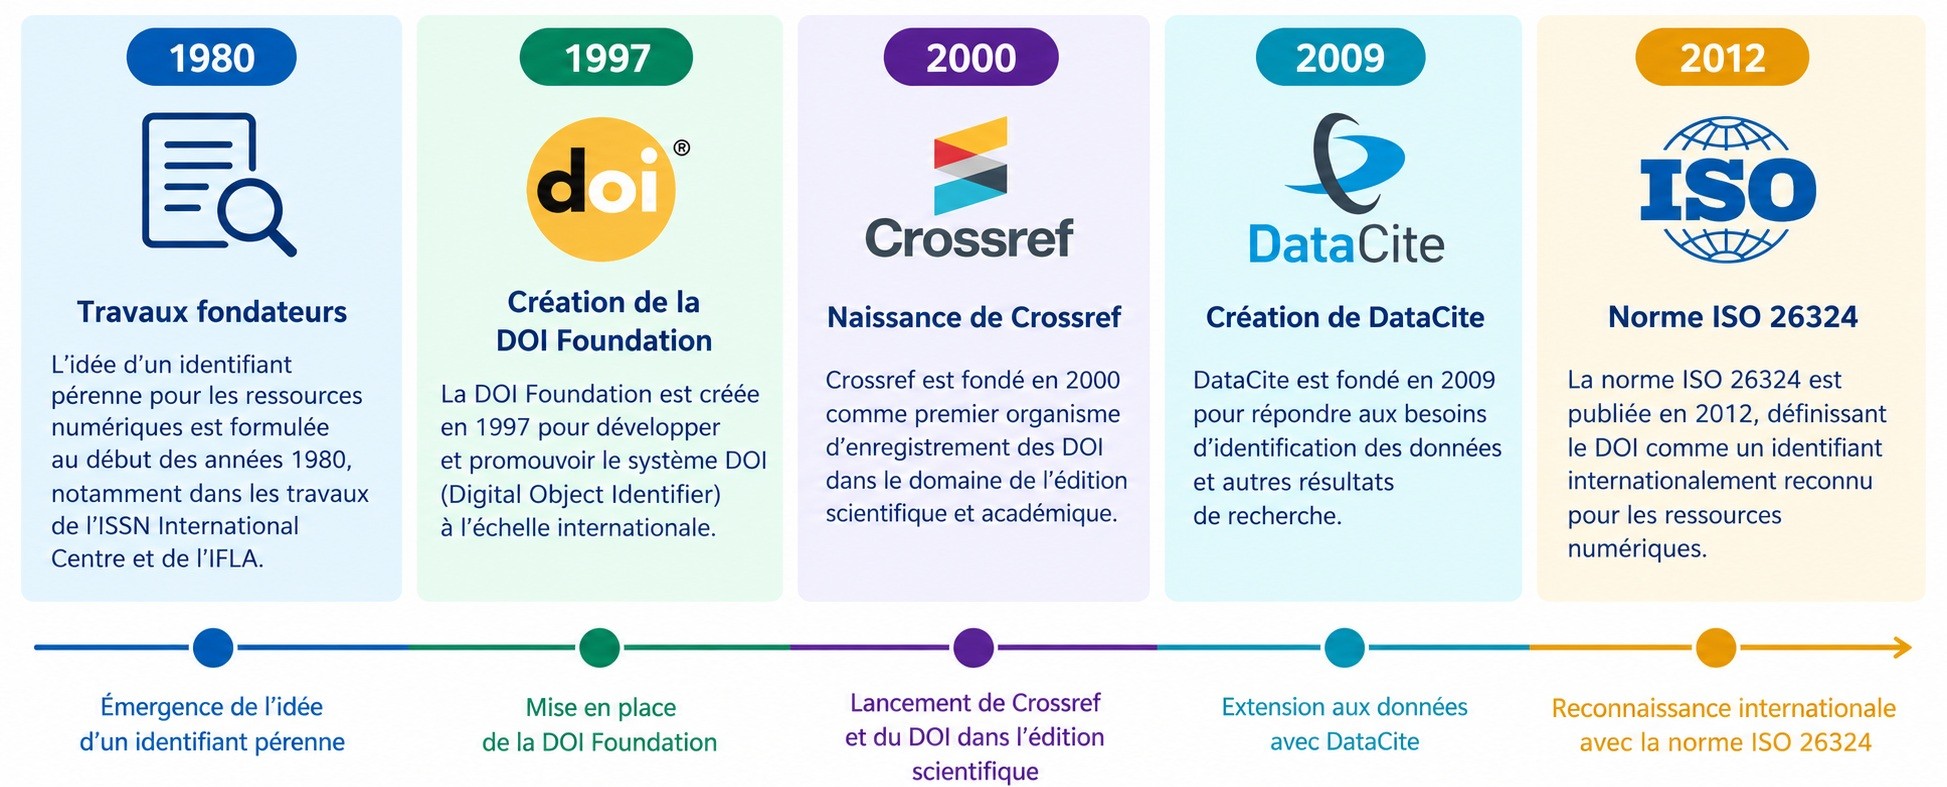
L’International DOI Foundation a été créée en 1997 pour créer un système commun à tous les acteurs. Dans le contexte de l’édition scientifique électronique, l’enjeu consistait à fournir un identifiant qui ne dépende pas de la syntaxe des URL des éditeurs. Crossref est ainsi la première structure de coopération entre éditeurs scientifiques, créée en 2000, orientée sur les références des articles scientifiques. En 2009, DataCite est lancé à son tour avec un spectre légèrement différent, visant à favoriser l’identification des données de recherche et d’autres objets scientifiques. Enfin la norme ISO 26324, publiée en 2012 et révisée en 2022, formalise le cadre du système DOI (Paskin, 2002 ; DOI Foundation, s.d.-a).
Ces différentes initiatives ont permis d’établir l’architecture actuelle, sans être une succession de technologies se remplaçant les unes les autres :
- le système Handle fournit une infrastructure technique ;
- le DOI ajoute un cadre normatif, des règles d’attribution et des responsabilités institutionnelles ;
- les agences d’enregistrement proposent des schémas de métadonnées et des services adaptés à leurs communautés.
2.2. Le DOI : un identifiant, pas une adresse de stockage
Un DOI est composé de deux parties séparées par une barre oblique (ou slash) : dans l’exemple 10.34971/XWV8-PH95, la chaîne « 10.34971 » est le préfixe DOI et « XWV8-PH95 » son suffixe. Le préfixe identifie un espace d’attribution géré dans le cadre du système DOI, en général la revue. Il ne décrit ni la discipline scientifique ni nécessairement l’identité actuelle de l’éditeur. Le suffixe est quant à lui choisi selon les règles de l’organisme d’enregistrement et de l’entité déposante.
Sa forme ne doit pas être interprétée comme un code bibliographique universel : certains suffixes sont opaques, d’autres incorporent des éléments éditoriaux, mais la stabilité de l’identifiant importe davantage que sa lisibilité (DOI Foundation, s.d.-a).
Lorsqu’un lecteur saisit « https://doi.org/10.34971/XWV8-PH95 », son navigateur internet contacte un service de résolution (ou résolveur). Celui-ci utilise les informations associées au DOI pour rediriger vers une URL de destination. Cette opération est invisible pour le lecteur, aboutissant normalement à une page descriptive de l’article, qui ne propose pas toujours le texte intégral de l’article, en fonction de la politique de l’éditeur. Il peut s’agir d’un résumé, de la liste des auteurs ou uniquement des informations de citation.
Le document n’est donc pas stocké sur doi.org. L’URL de destination et les métadonnées bibliographiques constituent deux ensembles d’informations liés, mais distincts. La distinction est essentielle pour comprendre la maintenance. Si une revue change de domaine ou réorganise ses pages, il faut qu’il actualise les destinations des DOI concernés. Il n’est pas nécessaire de fabriquer de nouveaux identifiants. À l’inverse, attribuer un nouveau DOI à chaque déplacement de page contredirait le principe même de persistance. Le lecteur et les systèmes bibliographiques doivent pouvoir utiliser la même chaîne d’identification dans la durée.
2.3. La persistance des DOI dépend d’une maintenance active
Comme évoqué plus haut, la continuité des DOI est un enjeu central du dispositif. On peut en distinguer trois niveaux : 1) La persistance de l’identifiant signifie que la chaîne DOI demeure associée à la même ressource intellectuelle ; 2) La continuité de résolution signifie que le service renvoie vers une destination valide ; 3) La pérennité documentaire exige enfin que le contenu lui-même soit conservé et accessible dans des conditions satisfaisantes. Les trois objectifs se renforcent, mais aucun ne garantit à lui seul la persistance des DOI (Klein et al., 2014 ; Jones et al., 2016).
La stabilité de la page d’atterrissage mérite à ce titre une attention particulière de la part de l’éditeur. Une redirection vers la page d’accueil d’une revue, vers une erreur 404 ou vers un fichier isolé dépourvu de contexte bibliographique ne remplit qu’imparfaitement la promesse de l’identification pérenne.
Les bonnes pratiques éditoriales consistent donc à maintenir une page propre à chaque article, à y afficher le DOI et les métadonnées essentielles, et à préserver autant que possible l’accès aux versions publiées. La conservation numérique à long terme, éventuellement confiée à des dispositifs d’archivage spécialisés (cf. § 11.4), est une responsabilité complémentaire. L’ensemble de ces concepts est synthétisé dans la figure 1.
3. Gouvernance du système DOI et diversité des agences d’enregistrement
L’architecture institutionnelle est parfois mal comprise parce que l’utilisateur ne voit généralement qu’un lien commençant par doi.org. La DOI Foundation assure le cadre de gouvernance et de normalisation du système. Les agences d’enregistrement, telles que Crossref et DataCite, opèrent quant à elles des services d’attribution, de maintenance et de diffusion des métadonnées dans le cadre des politiques applicables à leurs communautés.
Les membres ou déposants fournissent aux agences les informations relatives aux objets qu’ils publient et doivent en assurer la mise à jour (DOI Foundation, s.d.-c ; Hendricks et al., 2020).
Cette répartition des rôles permet d’expliquer pourquoi un DOI n’est pas la propriété d’une plateforme de publication. L’éditeur peut en effet décider de changer d’hébergeur ou de prestataire technique, voire d’agence d’enregistrement, tout en conservant l’identifiant DOI associé à chaque article. Les obligations ne disparaissent pas pour autant : il faut qu’une entité demeure responsable de l’enregistrement, des métadonnées et de la destination du DOI. La gouvernance de la persistance repose ainsi sur des engagements humains et organisationnels, et pas sur une simple propriété du protocole informatique.
D’autres identifiants que les DOI interviennent dans cet écosystème. Les deux plus importants sont ORCID, qui permet d’identifier les chercheurs, et ROR pour les identifiants d’organisations et d’institutions. En outre, des DOI peuvent être attribués à des jeux de données, logiciels ou autres objets scientifiques. Les relations explicites entre ces identifiants constituent une infrastructure de connaissance distribuée, parfois décrite sous la forme d’un « graphe d’identifiants pérennes », ou « PID Graph » (Meadows et al., 2019 ; Cousijn et al., 2021).
3.1. Une fédération d’agences
Le système DOI repose sur une fédération d’agences d’enregistrement (Registration Agencies ou RA), dont le cadre de gouvernance commun est régi par la DOI Foundation. Chaque agence alloue des préfixes, enregistre les identifiants et permet la déclaration et la mise à jour des métadonnées nécessaires à leur résolution. En revanche, les agences peuvent adopter des modèles économiques, des schémas descriptifs et des services spécialisés distincts (DOI Foundation, s.d.-c).
L’appartenance à cette fédération n’implique donc pas une base bibliographique unique. La résolution d’un DOI et la possibilité de consulter ses métadonnées auprès d’une agence ne doivent pas être confondues. Un DOI enregistré auprès de DataCite peut être résolu par doi.org sans pour autant figurer comme une notice native dans l’API bibliographique de Crossref. Inversement, l’identifiant lui-même ne révèle pas nécessairement l’agence actuellement en charge de son enregistrement. Cette distinction est déterminante lorsqu’un corpus est transféré d’une agence à une autre (cf. §6).
3.2. Une diversité de domaines et de communautés
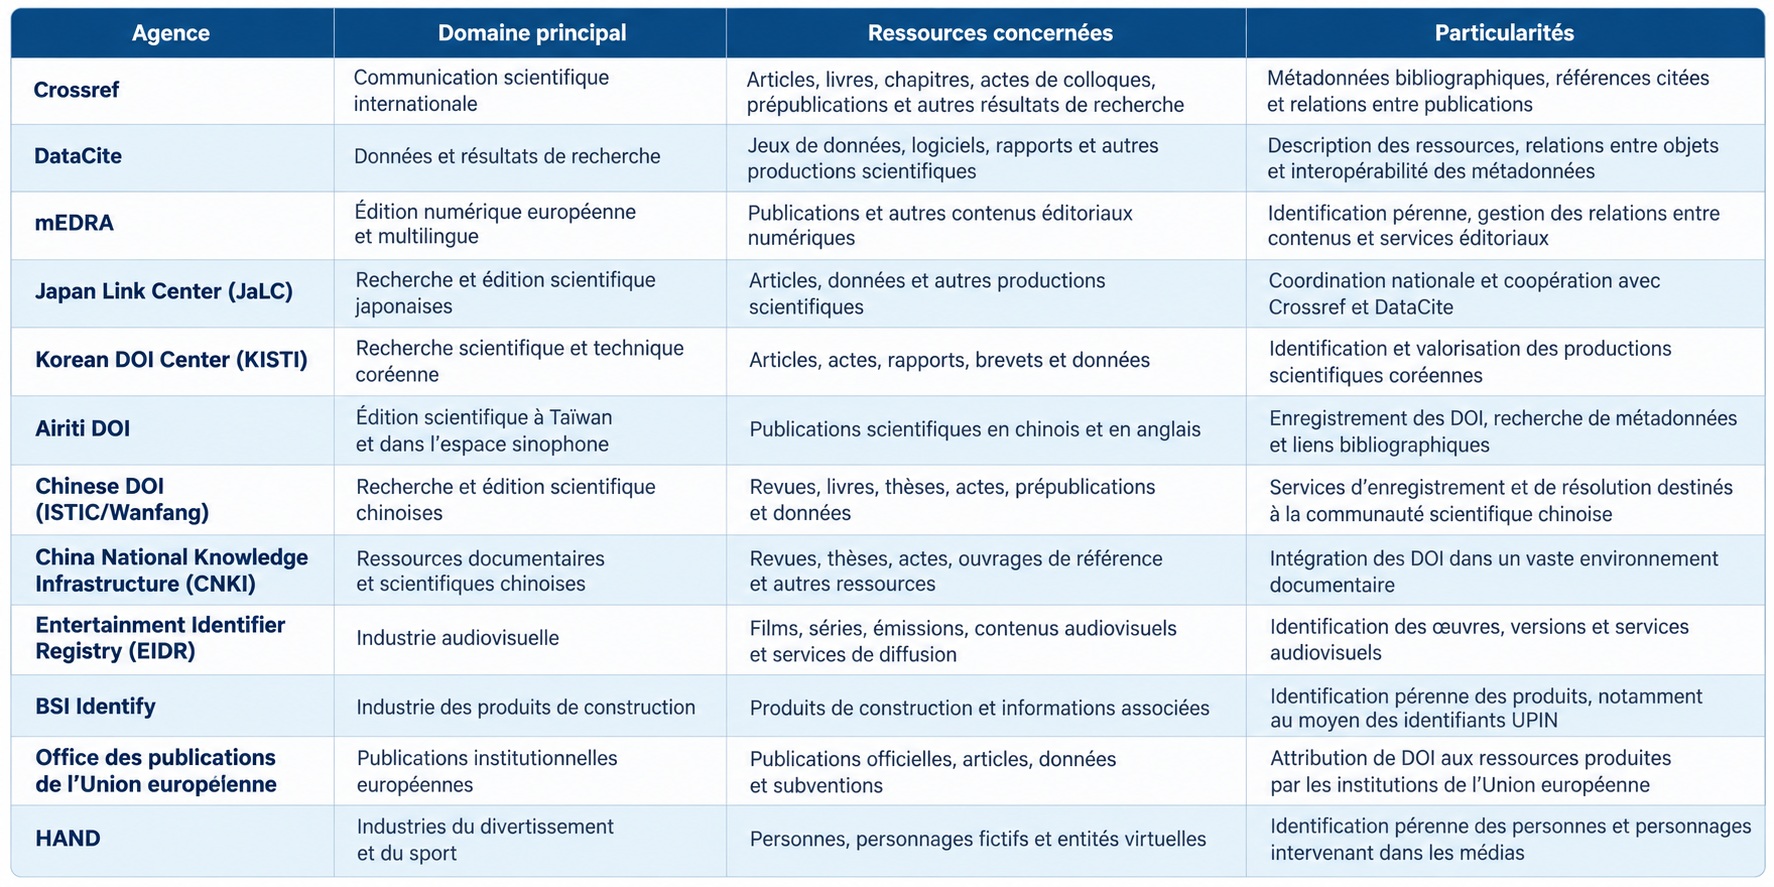
Crossref et DataCite sont les deux agences les plus visibles dans le monde académique. Toutefois, la liste officielle des agences montre que les DOI existent dans des secteurs très divers : édition multilingue, ressources nationales de recherche, documents des institutions européennes, audiovisuel, produits de construction et identification de talents. Le DOI est donc un cadre technique transversal, mais pas un format réservé à l’article scientifique (DOI Foundation, s.d.-b). Le tableau 1 illustre cette diversité : pour connaître les agences reconnues à une date donnée, il convient de consulter le répertoire officiel actualisé de la DOI Foundation.
3.3. Rappels chronologiques
Les réflexions sur l’identification persistante des objets numériques précèdent l’annonce du DOI en 1997. Crossref est lancé en 2000 pour faciliter notamment les liens entre publications, tandis que DataCite apparaît en 2009 dans le contexte de la citation et de la reconnaissance des données de recherche. L’adoption de la norme ISO 26324, puis sa révision inscrivent ce dispositif dans un cadre de normalisation international. La figure 2 présente ces jalons.
3.4. Comment une revue scientifique doit-elle choisir son agence d’enregistrement ?
Même si des critères économiques peuvent intervenir (les agences n’ayant pas la même tarification de leurs services), le choix de dépôt de ses DOI doit prioritairement répondre aux besoins documentaires et techniques de l’éditeur. Pour une revue scientifique indépendante, les principaux critères sont la nature des publications à identifier, les métadonnées acceptées (et donc à partager), les facilités de dépôt et de mise à jour, la gestion des références bibliographiques, et secondairement les modalités d’accompagnement technique et administratif.
Il convient par ailleurs de distinguer les fonctions des différents intervenants. L’agence d’enregistrement assure la gestion des DOI dans le cadre du système international, tandis que la plateforme éditoriale héberge et diffuse les publications. Un prestataire technique peut préparer ou transmettre les métadonnées pour le compte de l’éditeur, sans être lui-même une agence d’enregistrement. De même, les moteurs de recherche et les bases bibliographiques exploitent les identifiants et les notices sans nécessairement participer à leur attribution.
Il faut savoir que les agences présentent des orientations historiques et des services différents, à qualité et pérennité des DOI comparables. Le cas de Crossref et de DataCite, particulièrement pertinent pour les publications et les données scientifiques, est examiné au chapitre 5.
4. Les métadonnées : de l’identification à l’interopérabilité
La présence d’un DOI dans un article n’est que la partie visible d’un dispositif documentaire plus large. Lors de l’enregistrement, l’éditeur dépose un fichier XML composé d’un ensemble de métadonnées structurées, tel qu’établi dans un cahier des charges fourni par l’agence choisie (par exemple la version Crossref 5.5.0 à l’heure de rédaction de ces lignes). Ces métadonnées permettent à des services tiers de découvrir, citer, relier et analyser la publication. Elles sont exploitées par des catalogues, des moteurs de recherche, des outils bibliographiques, etc. La valeur collective du système dépend donc autant de la qualité de ses notices que de la stabilité des identifiants (Hendricks et al., 2020 ; Cousijn et al., 2021).
Il faut distinguer la validité technique d’un dépôt et la qualité documentaire de son contenu. En effet, un fichier XML peut être conforme au cahier des charges, et donc accepté sans erreur, tout en omettant des informations utiles ou en contenant des valeurs inexactes. La validation structurelle contrôle des règles de format, mais elle doit être complétée par la vérification éditoriale, qui porte sur l’exactitude des noms, titres, dates, relations et références. Les comparaisons de bases bibliographiques montrent que la complétude des métadonnées varie sensiblement selon les plateformes et les champs examinés (Delgado-Quirós & Ortega, 2024).
4.1. Une priorité : décrire correctement les publications
La visibilité et le partage d’une publication déposée sur une agence dépendent incontestablement de la qualité des informations déposées via le fichier XML. Il est en effet possible de déposer un fichier conforme mais limité aux seuls champs obligatoires. L’idéal est de ne pas se limiter aux informations d’identification (DOI, titre, auteurs, revue, ISSN, date de publication), de localisation (URL de la page d’atterrissage) et de structuration éditoriale (volume, numéro, pages ou numéro d’article), mais, si le schéma le permet, d’y apposer des informations complémentaires comme : les affiliations, les financements, les licences, les résumés ou les relations avec d’autres objets.
D’un point de vue technique, les formats d’échange imposent une discipline particulière. Le dépôt XML compte des éléments organisés selon une grammaire établie par chaque agence : ordre des balises, attributs, caractères réservés et valeurs autorisées peuvent conditionner l’acceptation du fichier. Une esperluette non échappée (lue alors comme un élément de code), une date incohérente ou une balise mal fermée peuvent suffire à bloquer un dépôt.
Les schémas Crossref et DataCite ne sont pas identiques ; un transfert exige donc la réalisation d’un autre fichier XML et non une simple copie de fichier (Crossref, 2026 ; DataCite Metadata Working Group, 2026).
Le contrôle des noms d’auteurs constitue un autre enjeu. Les variantes typographiques, les initiales et les homonymies peuvent compliquer l’attribution des travaux. L’association des noms à des identifiants personnels, comme les identifiants ORCID pour les chercheurs, facilite les rapprochements. Il en va de même des affiliations institutionnelles et des relations entre articles, jeux de données ou versions successives. Par contre, il vaut mieux laisser un champ facultatif vide que lui attribuer une information incertaine.
4.2. Les références bibliographiques et les citations ouvertes
Une liste de références bibliographiques déposée auprès de Crossref peut être utilisée pour établir des liens entre les publications citantes et citées. Les services d’appariement cherchent à identifier les documents mentionnés à partir de leurs informations bibliographiques et, lorsque cela est possible, à leur associer un DOI. Parfois, une référence peut être correctement enregistrée sans qu’une correspondance avec un DOI ne soit établie.
Les citations ouvertes désignent les relations bibliographiques entre publications rendues librement accessibles sous forme de données structurées et réutilisables. Leur disponibilité facilite la navigation dans les corpus scientifiques, les analyses bibliographiques et le développement d’outils de découverte (Shotton, 2013). Leur exploitation automatique dépend néanmoins de la qualité des références : des DOI incorrects, des informations incomplètes ou des données bibliographiques ambiguës peuvent entraîner des appariements manquants ou erronés (Cioffi et al., 2022).
Cette distinction revêt une importance particulière pour les revues de botanique, dont les bibliographies comprennent fréquemment des publications anciennes, des flores régionales, des monographies ou des documents non numérisés, le plus souvent dépourvus de DOI. L’absence d’appariement automatique ne constitue donc pas, à elle seule, un indice d’erreur bibliographique. La priorité demeure la conservation de références exactes et intelligibles, qu’elles soient ou non reliées à un DOI.
Biodiversity Heritage Library (BHL) joue un rôle particulier dans ce contexte. Cette bibliothèque numérique internationale donne accès à un vaste corpus de littérature historique sur la biodiversité, notamment des ouvrages de botanique, de taxonomie et de systématique. Elle propose des liens stables vers les documents et leurs pages, ainsi que des métadonnées exploitables par d’autres systèmes d’information. Ainsi, elle participe activement à l’attribution rétrospective de DOI à certaines publications anciennes, contribuant ainsi à leur intégration dans les réseaux contemporains de références bibliographiques et de citations (Biodiversity Heritage Library, s.d.).
Dans tous les cas, il est vivement recommandé d’inclure les références bibliographiques dans les fichiers XML de métadonnées déposés auprès des agences d’enregistrement des DOI, lorsque leurs schémas de dépôt le permettent, que ces références soient automatiquement associées à un DOI ou pas.
4.3. Les principes FAIR : définition et portée
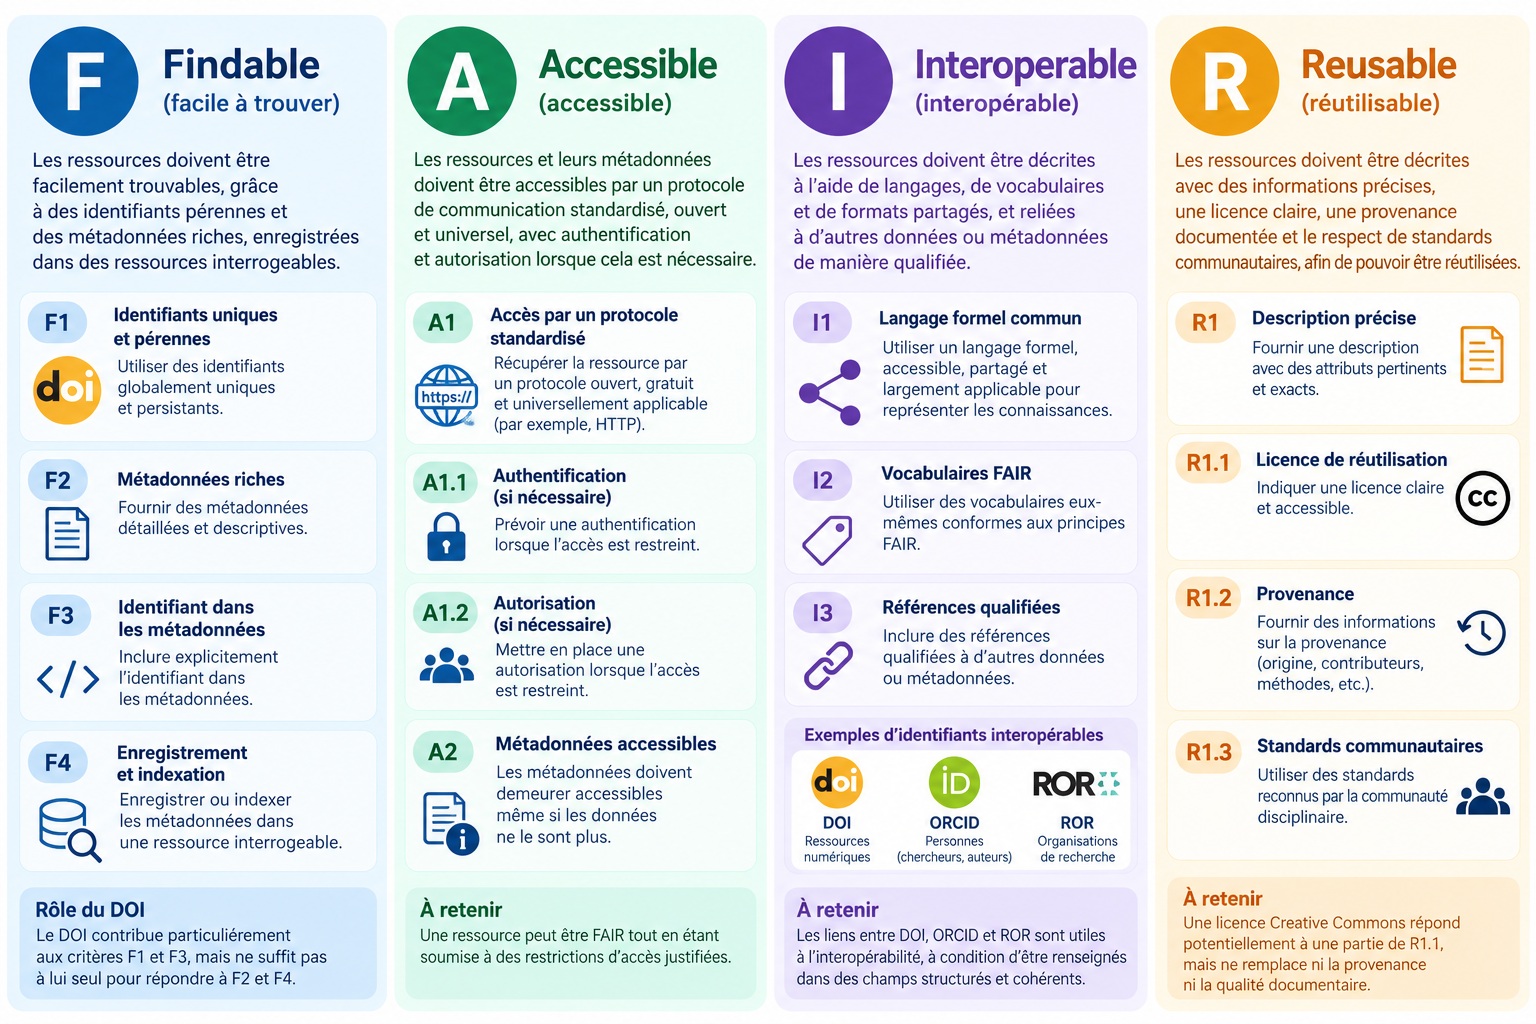
Les principes FAIR (Findable, Accessible, Interoperable, Reusable) ont été proposés par Wilkinson et al. en 2016. Leur volonté était d’établir des objectifs communs pour les différents outils numériques de la recherche scientifique. Leur respect est censé permettre aux hommes comme aux systèmes informatiques de trouver, consulter, mettre en relation et réutiliser les ressources scientifiques numériques (Dacos, 2019). Initialement élaborés dans le domaine de la gestion des données de recherche, ils concernent également les publications scientifiques et leurs métadonnées.
Ces principes reposent sur quatre exigences complémentaires :
- la facilité de repérage des ressources (F) ;
- leur accessibilité selon des modalités clairement définies (A) ;
- leur interopérabilité avec d’autres systèmes d’information (I) ;
- et les conditions permettant leur réutilisation (R).
Dans le détail, ils se déclinent en quinze sous-principes (figure 3), qui précisent notamment le rôle des DOI, l’impact de la richesse des métadonnées, l’utilisation de protocoles standardisés, la description des droits et la documentation sur la provenance des ressources.
Le respect des principes FAIR ne signifie pas qu’une ressource sera obligatoirement validée, notamment lors de son dépôt dans une agence numérique. De même, une ressource soumise à des restrictions d’accès peut satisfaire certaines exigences FAIR, même si elle n’est pas pour autant en libre accès. A contrario, la mise à disposition gratuite d’un document ne garantit ni son interopérabilité ni sa réutilisabilité.
De façon générale, l’appréciation de ces principes doit tenir compte de l’objet concerné : le texte intégral d’un article, ses données associées et sa notice bibliographique peuvent présenter des niveaux différents de conformité.
4.4. Les principaux identifiants disponibles pour mettre en œuvre les principes FAIR
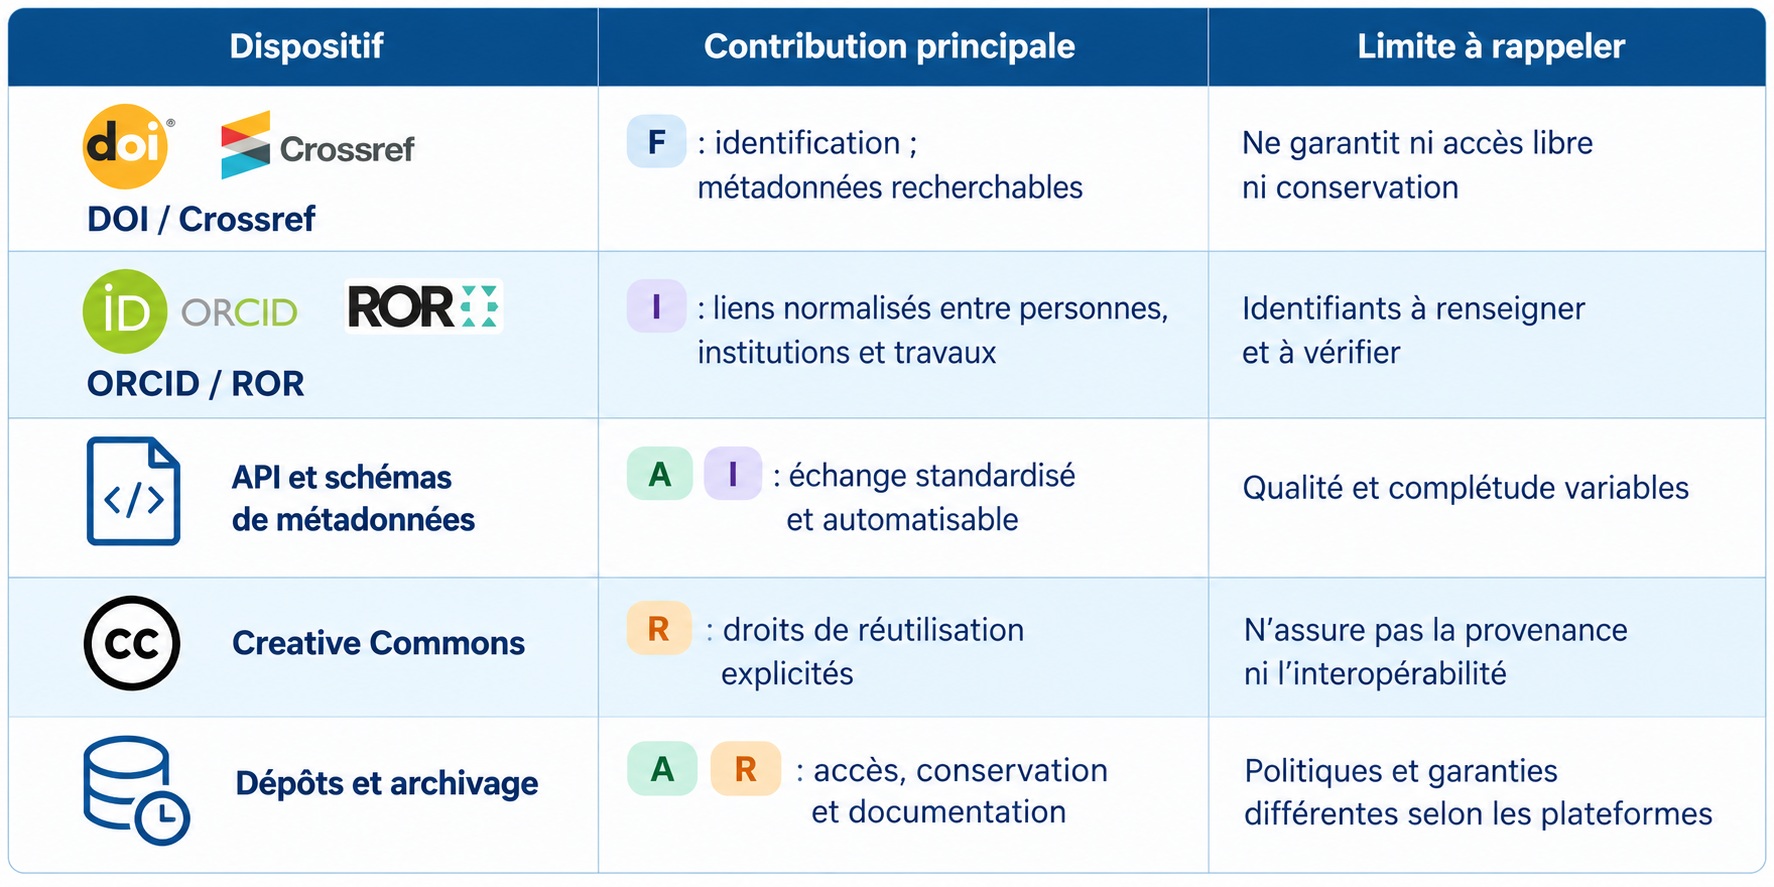
La mise en œuvre des principes FAIR dans l’édition scientifique numérique repose sur l’articulation de plusieurs dispositifs. Les différents identifiants pérennes y jouent un rôle primordial, mais ils ne répondent pas à eux-seuls à l’ensemble des principes. Pour cela, ils doivent être associés à des métadonnées suffisamment riches, à des modalités d’accès explicites et à une documentation permettant de comprendre, relier et réutiliser les ressources.
Le DOI est évidemment l’élément central de la facilité de repérage des publications, en leur attribuant un identifiant unique et pérenne, qui peut être intégré aux métadonnées et utilisé dans différents systèmes d’information. Les identifiants ORCID et ROR complètent ce dispositif en facilitant respectivement l’identification des chercheurs et celle de leurs organismes d’affiliation. Lorsque ces informations sont correctement renseignées dans des champs structurés, elles permettent d’établir des relations entre les publications, auteurs, institutions et données de recherche. Cette logique rejoint les travaux sur les graphes d’identifiants pérennes ou PID Graph (Cousijn et al., 2021).
L’ISSN (International Standard Serial Number) est quant à lui un identifiant international normalisé destiné aux publications en série, notamment les revues scientifiques, journaux, bulletins et collections éditoriales. Régi par la norme ISO 3297:2022, il se compose de huit caractères (deux groupes de quatre), séparés par un trait d’union. Le dernier caractère constitue une clé de contrôle. Contrairement au DOI d’un article, l’ISSN identifie une publication en série dans son ensemble, en relation avec son titre et son support de diffusion (Bibliothèque nationale de France, s.d.).
Une même revue publiée sur plusieurs supports, notamment imprimé et électronique, possède en principe un ISSN distinct pour chaque support ; l’ensemble est relié par un ISSN de liaison (ISSN-L).
La gouvernance du système repose sur le réseau de l’ISSN, coordonné par le Centre international de l’ISSN, établi à Paris. Celui-ci administre ce registre international et coordonne les centres nationaux chargés de l’attribution des identifiants. En France, cette mission est confiée au Centre ISSN France, au sein de la Bibliothèque nationale de France (BnF).
L’attribution d’un ISSN à une revue n’est pas une obligation et ne constitue donc ni une autorisation de publication ni une certification de la qualité scientifique de celle-ci (Centre international de l’ISSN, s.d.). Pour autant, l’ISSN est une métadonnée essentielle dans les dépôts DOI : il permet notamment de rattacher les articles identifiés à la revue qui les publie. Ainsi, pour Carnets botaniques (ISSN 2727-6287), l’ISSN identifie la revue, tandis que les DOI enregistrés auprès de Crossref identifient ses articles individuellement. Ces identifiants sont complémentaires dans l’organisation de l’information scientifique.
Les interfaces de programmation (ou API) favorisent, quant à elles, l’échange et l’exploitation automatisée des informations, à condition que celles-ci soient exactes, suffisamment complètes et exprimées selon des conventions partagées.
Les licences Creative Commons contribuent à expliciter les droits de réutilisation, sans garantir à elles seules la qualité documentaire, la provenance ou l’interopérabilité des ressources. Enfin, les dépôts et les dispositifs d’archivage peuvent renforcer l’accessibilité et la conservation des publications, selon leurs politiques propres.
Comme cela vient d’être exposé, aucun dispositif ne permet donc à lui seul de satisfaire l’ensemble des principes FAIR. Leur mise en œuvre résulte de la complémentarité des identifiants, des métadonnées, des protocoles d’accès, des licences et des mécanismes de préservation. Le tableau 2 présente les principales contributions de ces dispositifs et les limites qu’il convient de leur reconnaître.
5. DataCite et Crossref : missions et complémentarités
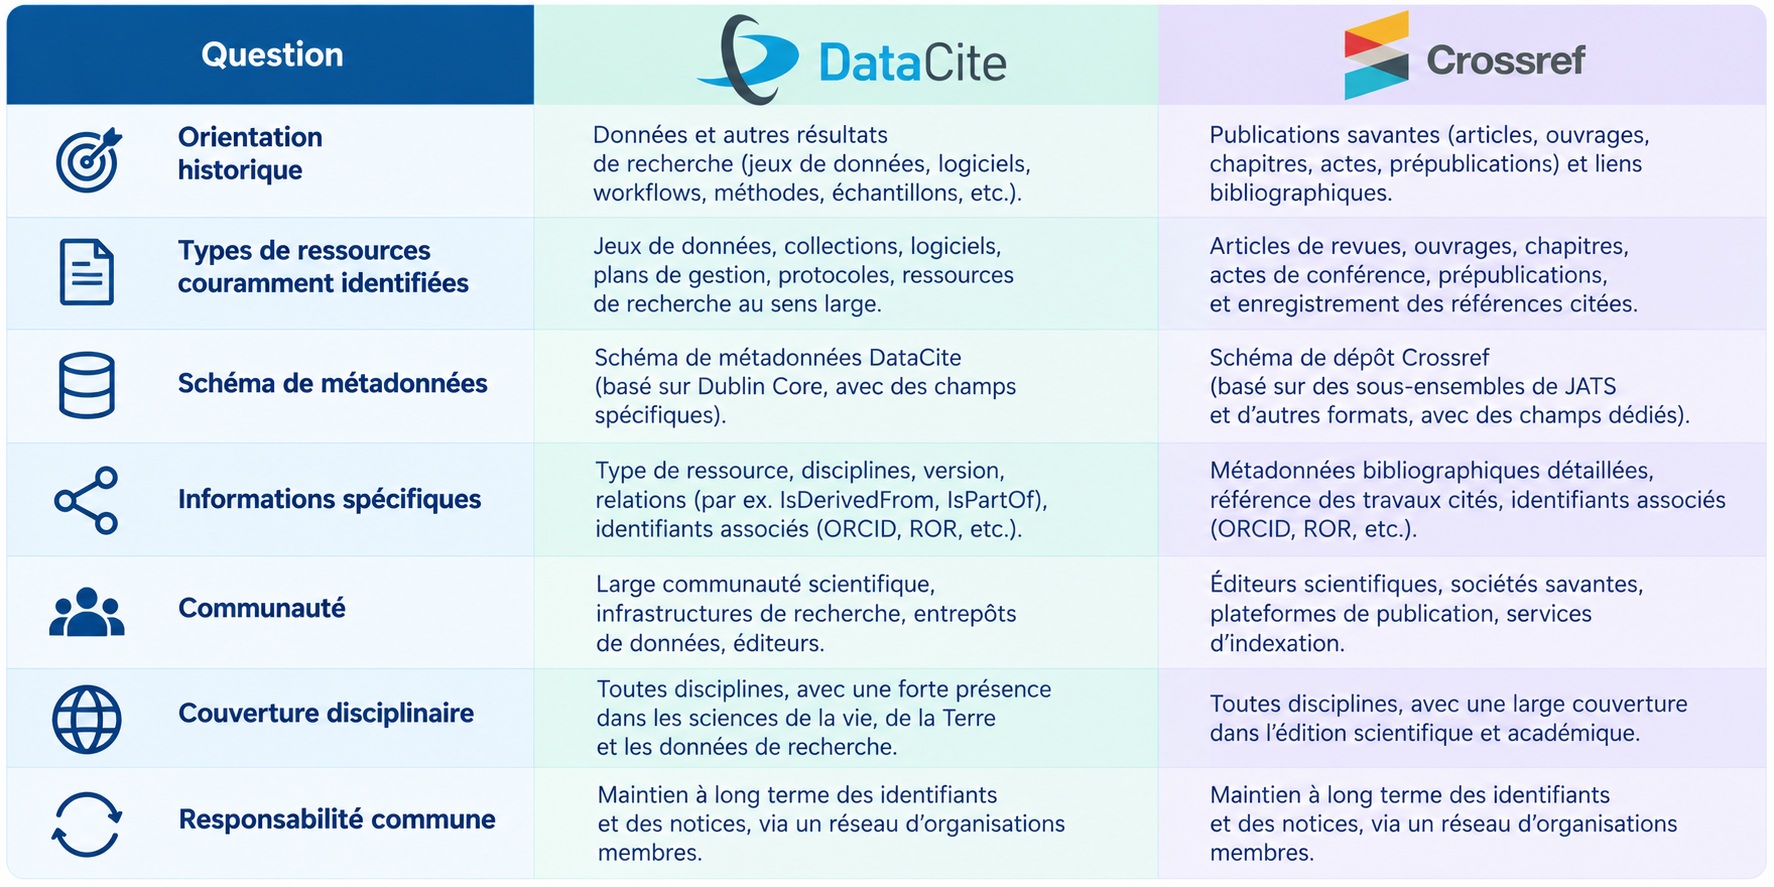
Crossref et DataCite sont les deux principales agences d’enregistrement appartenant au système DOI. Leurs orientations historiques dans l’organisation et l’exploitation des métadonnées ne sont pas identiques : Crossref a privilégié l’identification des publications savantes et des relations bibliographiques entre les articles, en établissant des liens entre articles citants et cités. DataCite a plutôt développé la généralisation de l’identification et la citation des données de recherche, avant d’étendre ses services à une diversité d’autres résultats scientifiques. Les deux approches participent ainsi à la constitution d’un réseau d’informations scientifiques interconnectées, mais selon des modèles documentaires et des services distincts.
Les catégories de ressources prises en charge par ces deux agences peuvent toutefois se recouper et les services proposés par les deux agences continuent d’évoluer (Hendricks et al., 2020 ; DataCite Metadata Working Group, 2026).
Cette complémentarité entre les deux agences peut conduire un même établissement ou une même communauté scientifique à utiliser plusieurs circuits d’enregistrement : les articles d’une revue peuvent être identifiés par des DOI enregistrés auprès de Crossref, tandis que les jeux de données associés peuvent relever de DataCite. Le tableau 3 synthétise les principales différences entre Crossref et DataCite, leurs domaines d’application et leurs responsabilités communes.
6. Migrer des DOI sans modifier les identifiants
Une migration entre agences d’enregistrement est une opération inhabituelle à l’échelle d’une petite revue, mais elle répond à une logique simple : préserver l’identité des objets tout en transférant la responsabilité de leur gestion. Il ne s’agit ni de republier les articles, ni de leur attribuer de nouveaux identifiants, ni de modifier leurs dates scientifiques de publication. Les documentations de Crossref et de DataCite prévoient des mécanismes de transfert de préfixe entre agences, sous réserve des démarches et accords nécessaires (Crossref, 2022 ; DataCite, 2026). Cette migration comporte quatre phases complémentaires :
1. une phase administrative (accords et rattachement du préfixe),
2. une phase documentaire (inventaire, conversion et contrôle des notices),
3. une phase technique (dépôt et analyse des diagnostics),
4. une phase de vérification publique (résolution des DOI et consultation des notices).
6.1. Transfert de préfixe et réenregistrement des notices
Le transfert d’un préfixe n’induit pas la disponibilité immédiate de notices complètes dans la nouvelle agence. La revue doit pour cela inventorier les DOI concernés, préparer les métadonnées dans le format requis (selon le cahier des charges) et procéder aux dépôts selon la procédure convenue. Le maintien de la chaîne DOI constitue la contrainte structurante de l’opération.
La conversion des métadonnées exige de traiter les correspondances entre champs. Un même concept bibliographique peut être représenté par des éléments différents selon le schéma ; certains champs peuvent être obligatoires dans l’un et facultatifs dans l’autre. Les références citées, lorsqu’elles sont disponibles, nécessitent une attention supplémentaire. Les contrôles doivent notamment porter sur l’unicité des DOI, l’association correcte des titres et auteurs, les dates, les URL et l’absence de notices manquantes.
6.2. Préparation, contrôle et risques
Une méthode prudente commence par la réalisation d’un inventaire des notices et des DOI historiques. On constitue ensuite un tableau de correspondance entre chaque article, son identifiant, son URL et son statut de dépôt.
Après la génération du fichier XML de test, un contrôle de conformité interne précède un premier essai sur un petit nombre de DOI ; ce contrôle est facilement réalisable à l’aide d’une IA pour les non-informaticiens. Le résultat du test est examiné avant de produire le lot complet. Cette approche réduit le risque de découvrir, après un dépôt massif, une erreur répétée sur toutes les notices.
Dès l’envoi du fichier XML de test, l’agence renvoie automatiquement un diagnostic à partir de son outil de test de fichier (pour Crossref le « Crossref XML spacer »). Il doit être lu avec précision. Un message de succès indique que la notice a été acceptée ; il ne signifie pas nécessairement que toutes les références bibliographiques ont été appariées, que chaque champ facultatif est renseigné ou que les pages de destination sont accessibles. De même, un avertissement documentaire n’équivaut pas toujours à un rejet. Il faut distinguer les échecs de validation, les avertissements, les informations relatives à l’appariement des citations et les vérifications réalisées sur les interfaces publiques.
Enfin, la migration ne se termine pas avec la soumission du dernier fichier. Il est recommandé de conserver les rapports de traitement, de tester un échantillon représentatif de DOI anciens et récents, de vérifier la présence des notices dans les services de la nouvelle agence et de documenter la procédure de dépôt des futurs articles.
7. Étude de cas : migration des DOI de Carnets botaniques
Carnets botaniques, la revue publiée par la Société botanique d’Occitanie (SBOcc), constitue un cas instructif car la migration des DOI a concerné un corpus rétrospectif entier, sans renumérotation des articles ni modification des identifiants. Le préfixe historique 10.34971 a été conservé. La démarche visait à inscrire la gestion future des DOI de la revue dans l’environnement Crossref, tout en maintenant la continuité des références déjà présentes dans les publications, catalogues et bibliographies.
7.1. Contexte et objectifs
Le corpus historique de la revue comprenait 314 articles publiés entre 2020 et 2026. Les notices avaient été initialement enregistrées dans l’écosystème DataCite avec l’accompagnement de l’Inist-CNRS. L’objectif prioritaire était de conserver intégralement les DOI existants, afin de ne pas rompre les citations déjà diffusées. Un second objectif consistait à transférer les métadonnées bibliographiques dans le format attendu par Crossref, avec notamment un enrichissement par les références citées.
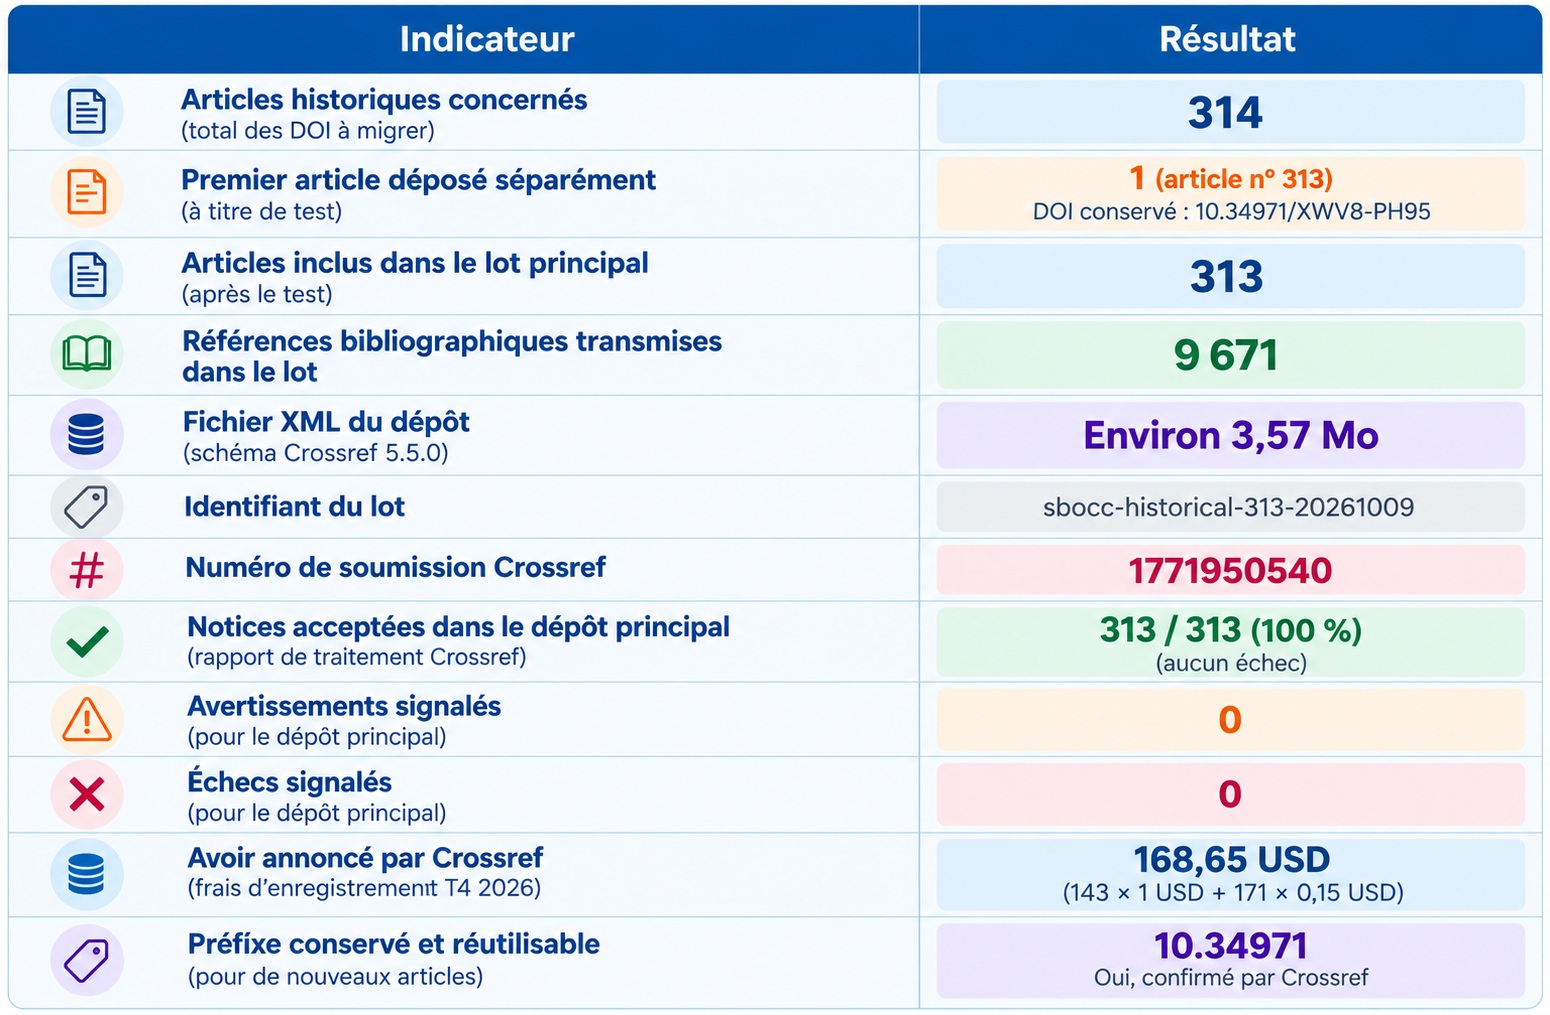
Le périmètre de l’opération a été clairement délimité : les 314 articles historiques ont été traités comme un ensemble à réenregistrer, tandis que les nouveaux articles pouvaient relever directement de la procédure Crossref. La distinction entre données rétrospectives et courantes a également été nécessaire pour le suivi administratif et financier. Pour les 314 articles historiques, le décompte établi était de 171 notices pour 2020-2023 et 143 pour 2024-2026.
7.2. Préparation et dépôts
La préparation technique a été assurée par le webmaster de la Société botanique d’Occitanie. Elle a nécessité la constitution d’un fichier XML conforme au schéma de dépôt Crossref 5.5.0, la reprise des métadonnées des articles et l’intégration de leurs références bibliographiques. La mise en conformité du fichier après la résolution des anomalies repérées lors des contrôles internes a été une étape majeure de la phase de préparation. Concrètement, sans maîtrise informatique suffisante au niveau de la revue, ces contrôles ont été réalisés à l’aide d’une IA.
Après validation de la structure du fichier test, un premier article, le numéro 313, a été réenregistré séparément dans Crossref, sans modification de son DOI (10.34971/XWV8-PH95). Après validation de cette étape par le spacer de Crossref, un dépôt groupé des 313 articles historiques restants a été effectué. Le fichier XML global, d’environ 3,57 Mo, contenait également 9 671 références bibliographiques. Le lot portait l’identifiant sbocc-historical-313-20261009 et la soumission Crossref le numéro 1771950540. Le rapport de traitement de Crossref a confirmé l’acceptation des 313 notices du lot principal, sans avertissement ni échec. Ce résultat atteste la réussite du dépôt des métadonnées, sans certifier l’appariement de l’ensemble des références bibliographiques.
Le service d’assistance de Crossref a rapidement confirmé l’achèvement opérationnel de la procédure de réenregistrement des 314 DOI historiques de Carnets botaniques. Il a également annoncé l’application d’un avoir de 168,65 USD sur la facture des frais liés à cette migration, correspondant à 143 enregistrements facturés à 1 USD et à 171 enregistrements facturés à 0,15 USD. Cet avoir a neutralisé le coût des réenregistrements. Crossref a également confirmé que la Société botanique d’Occitanie pouvait désormais utiliser son préfixe DOI 10.34971 pour enregistrer de nouveaux articles, ou des articles anciens dépourvus de DOI. Cette confirmation a marqué l’achèvement opérationnel de la migration (tableau 4).
7.3. Vérification et portée du résultat
La revue a ensuite procédé à une vérification par sondage de la présence des articles dans Crossref et de la conservation de leurs DOI ; au total une vingtaine d’articles ont été vérifiés. Elle a confirmé que les identifiants historiques avaient été maintenus. La réussite technique du réenregistrement est ainsi étayée par deux éléments complémentaires : le rapport d’acceptation des dépôts par Crossref et le contrôle des notices publiquement consultables par la Société botanique d’Occitanie.
La coordination entre les deux agences d’enregistrement a également fait l’objet d’un suivi auprès de l’Inist-CNRS, dans le cadre du service PID OPIDoR. Rapidement, ce service a indiqué à la SBOcc que DataCite international avait reçu la confirmation de Crossref et devait procéder aux opérations nécessaires concernant les anciens DOI enregistrés. Cette information confirme la coordination remarquable entre les deux agences.
Le résultat présente une portée pratique pour d’autres revues : il montre qu’un corpus historique peut changer d’agence d’enregistrement sans perdre ses identifiants, à condition de préparer les métadonnées, de coordonner les interlocuteurs et de contrôler la migration.
8. Des DOI aux plateformes de visibilité scientifique : réseaux de chercheurs, indexation et réutilisation des métadonnées
8.1. Des fonctions différentes derrière une apparente proximité
L’enregistrement d’un DOI ne se limite pas à fournir un lien stable vers un article. Il crée également un point d’ancrage pour la circulation de données bibliographiques entre des infrastructures distinctes. Il importe donc de distinguer les organismes qui enregistrent les DOI des services qui les exploitent pour repérer, afficher, relier ou partager les publications. Cette distinction éclaire le rôle de Crossref dans l’architecture documentaire contemporaine (Hendricks et al., 2020 ; Meadows et al., 2019).
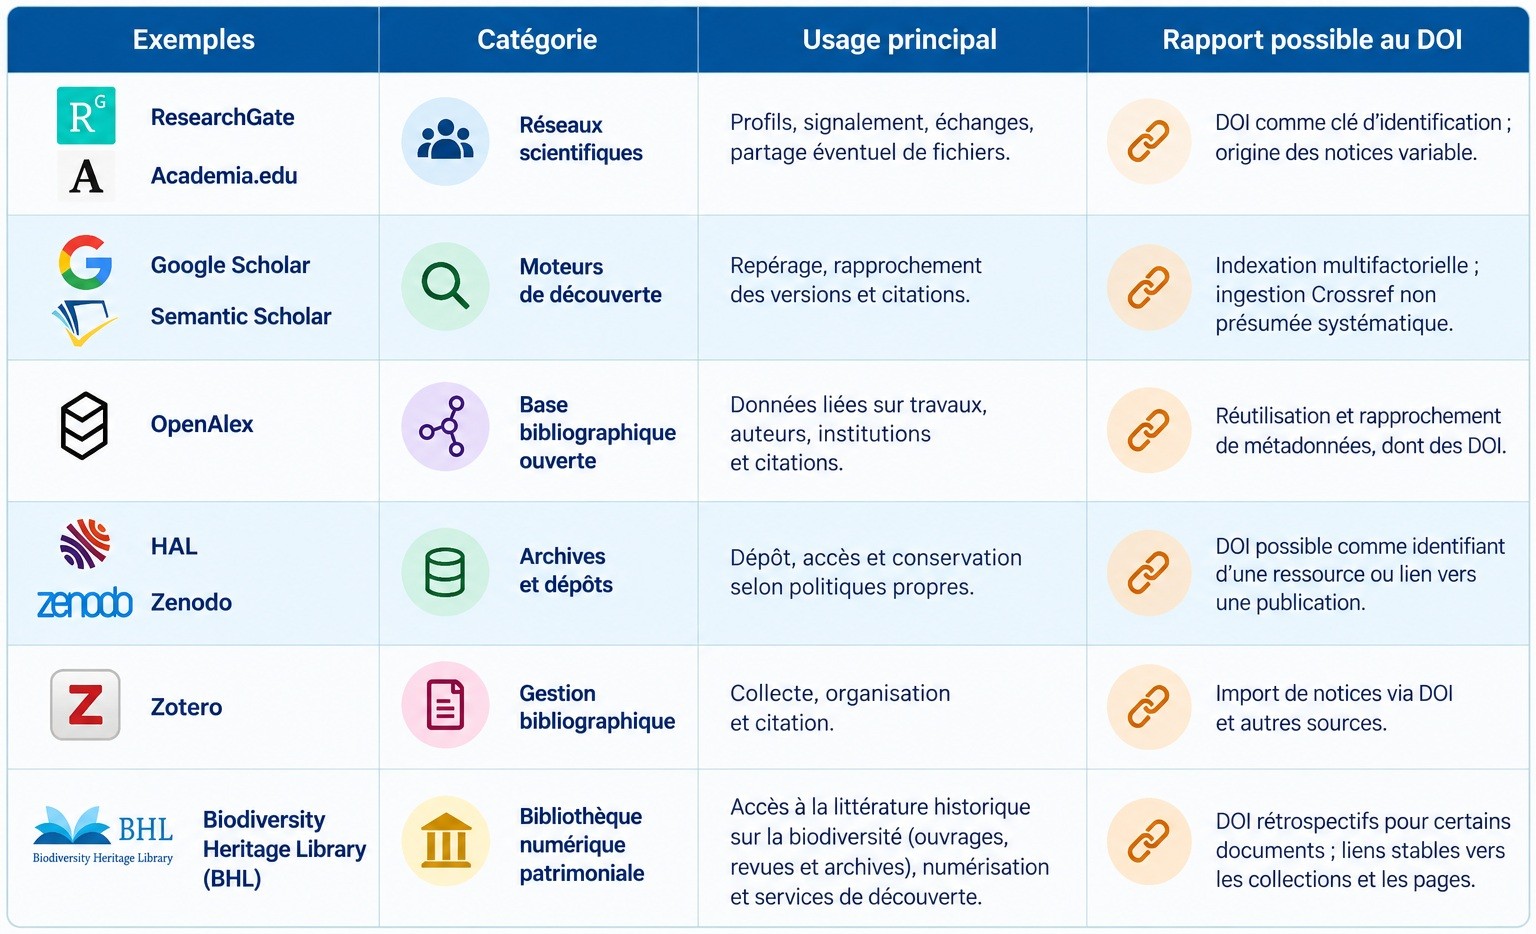
- ResearchGate et Academia.edu sont des réseaux ou plateformes de profils de chercheurs : ils permettent de signaler des travaux, de constituer une liste de publications et, dans certaines conditions, de partager des fichiers.
- Google Scholar et Semantic Scholar relèvent de la découverte et de l’indexation scientifique.
- OpenAlex construit un graphe ouvert de travaux, d’auteurs, d’institutions et de relations bibliographiques.
- HAL et Zenodo sont des infrastructures de dépôt et de diffusion.
- Zotero est un logiciel de gestion de références.
- Biodiversity Heritage Library (BHL) constitue une bibliothèque numérique patrimoniale spécialisée dans la littérature sur la biodiversité, associant numérisation, accès aux publications historiques, identification documentaire et services de découverte.
Ces services ne sont pas interchangeables et aucun d’entre eux ne doit être confondu avec Crossref ou avec une agence d’enregistrement de DOI. Le tableau 5 présente des fonctions dominantes, sans exclure que chaque service propose d’autres outils. La présence d’une publication sur une plateforme, sa « découvrabilité » dans un moteur, la disponibilité de son texte intégral et la qualité de sa notice sont quatre propriétés distinctes.
8.2. Le rôle de Crossref dans la circulation des notices
Comme nous l’avons vu, l’éditeur transmet à Crossref un ensemble structuré de métadonnées associé au DOI : titre, auteurs, source, dates, liens et, lorsque disponibles, résumés, identifiants complémentaires et références citées. Crossref met ces informations à disposition au moyen de services de recherche et surtout de son interface informatique appelée API REST. Des acteurs tiers peuvent alors les consulter, les enrichir ou les confronter à d’autres jeux de données. Les métadonnées déposées n’assurent toutefois ni une indexation immédiate ni une couverture uniforme par tous les services (Hendricks et al., 2020 ; Crossref, 2020). Les délais de récupération de ces données dépendent évidemment de chaque acteur, mais en pratique nous avons pu constater qu’ils étaient très courts, de l’ordre de quelques jours (par exemple entre Corssref et ResearchGate).
Une chaîne simplifiée est : publication par la revue → dépôt de métadonnées chez Crossref → exposition de ces métadonnées via l’API REST → réutilisation éventuelle par des services tiers → découverte par le lecteur. Dans la réalité, les chemins sont multiples : moissonnage du site de la revue, métadonnées intégrées aux pages HTML, flux institutionnels, saisie par les auteurs et bases agrégées interviennent également. Il serait donc inexact de représenter ResearchGate ou Google Scholar comme de simples interfaces de Crossref.
8.3. ResearchGate : visibilité, identification et ambiguïtés documentaires
Le cas de ResearchGate est particulièrement instructif parce qu’il combine profils de chercheurs, notices bibliographiques et partage éventuel de textes. Un DOI correctement enregistré peut aider à lever les ambiguïtés d’une publication, à la retrouver et à la relier à sa version éditoriale. Cependant, l’existence d’un DOI Crossref ne garantit pas la création d’une notice ResearchGate ni l’exactitude d’une notice déjà présente. Les mécanismes précis de collecte et de mise à jour de cette plateforme ne doivent pas être déduits de la seule existence d’une API Crossref.
Il faut également distinguer un article publié, son manuscrit accepté, une prépublication et un jeu de données associé. Des versions différentes d’un même travail peuvent légitimement porter des DOI distincts, à condition que leur nature et leurs relations soient correctement documentées. Inversement, des dépôts non coordonnés peuvent engendrer des notices en double ou des liens trompeurs. L’existence de plusieurs DOI associés à un même travail ne constitue donc pas nécessairement une erreur : leur interprétation doit tenir compte de la version identifiée, de la provenance de l’enregistrement et des relations déclarées entre les objets (NISO, 2026).
8.4. DOI, accès au texte intégral et droits de diffusion
La présence d’une notice dans un réseau scientifique ne signifie pas que le texte intégral est librement disponible. De même, un DOI résolu peut conduire vers une page de présentation, une ressource ouverte ou un contenu soumis à des conditions d’accès. Les modalités de dépôt de fichiers sur des plateformes tierces doivent être appréciées au regard des droits de l’auteur, de l’éditeur et des licences applicables. Le DOI est un instrument d’identification et de liaison, mais pas une licence de diffusion ni une garantie d’archivage.
8.5. Conséquences pratiques pour Carnets botaniques
La migration des 314 DOI historiques de Carnets botaniques vers Crossref permet désormais d’exposer les notices dans un environnement largement exploité par les services bibliographiques. Les 9 671 références transmises avec le lot historique constituent également une base de données susceptible d’améliorer les relations documentaires entre les articles de la revue et les référencés citées.
Parallèlement à cette migration, la revue Carnets botaniques dispose désormais d’une page dédiée sur la plateforme ResearchGate (https://www.researchgate.net/journal/Carnets-botaniques-2727-6287). Elle identifie la revue et son éditeur en chef, dont le rôle est désormais confirmé par la plateforme. Cette page constitue un point de visibilité supplémentaire de Carnets botaniques auprès de la communauté scientifique. Ce n’était pas le cas avec l’utilisation de l’agence DataCite.
Il serait néanmoins prématuré d’en conclure à une augmentation automatique de la visibilité des articles sur ResearchGate, Google Scholar ou OpenAlex : un tel effet doit être documenté empiriquement, plateforme par plateforme. Pour autant, à titre d’exemple, la page de la revue dans ResearchGate permet de visualiser en temps réel le nombre de chercheurs ayant consulté au moins un article de la revue pendant l’année en cours ; le suivi régulier de ce chiffre donnera une indication rapide sur l’accroissement de visibilité de Carnets botaniques grâce à cette migration.
Pour aller plus loin, un protocole reproductible pourrait sélectionner un échantillon d’articles de plusieurs années, relever pour chacun son DOI, sa présence et la qualité de sa notice sur Crossref, OpenAlex, Google Scholar et ResearchGate, puis renouveler l’observation après un délai défini.
9. DOI, droit d’auteur, libre accès et licences de réutilisation
9.1. Bien distinguer ces différents concepts
L’identification d’une publication scientifique ne préjuge en rien des modalités de son accès et des droits attachés à sa réutilisation. Cela relève des choix propres de la revue. Le DOI ne détermine ni les conditions de sa consultation ni les usages autorisés de son contenu. De même, le fait qu’un article soit mis à disposition gratuitement ne signifie pas automatiquement qu’il puisse être librement reproduit, adapté ou redistribué.
En ce sens, il faut distinguer les modèles de diffusion et de financement de ce qu’on appelle le « libre accès » (ou Open Access) des licences qui encadrent la réutilisation des publications. Par exemple, le modèle appelé « Diamond Open Access » s’applique à une publication accessible gratuitement pour les lecteurs et sans aucun frais de publication pour les auteurs. Une licence CC BY-NC-SA définit quant à elle les conditions juridiques de réutilisation du contenu, indépendamment de son mode de financement.
Dans ce chapitre, seront détaillées les principales voies du libre accès (9.2), les licences Creative Commons (9.3) et des modalités de déclaration des informations de licence dans les métadonnées Crossref (9.4).
9.2. Les principales voies du « libre accès » scientifique
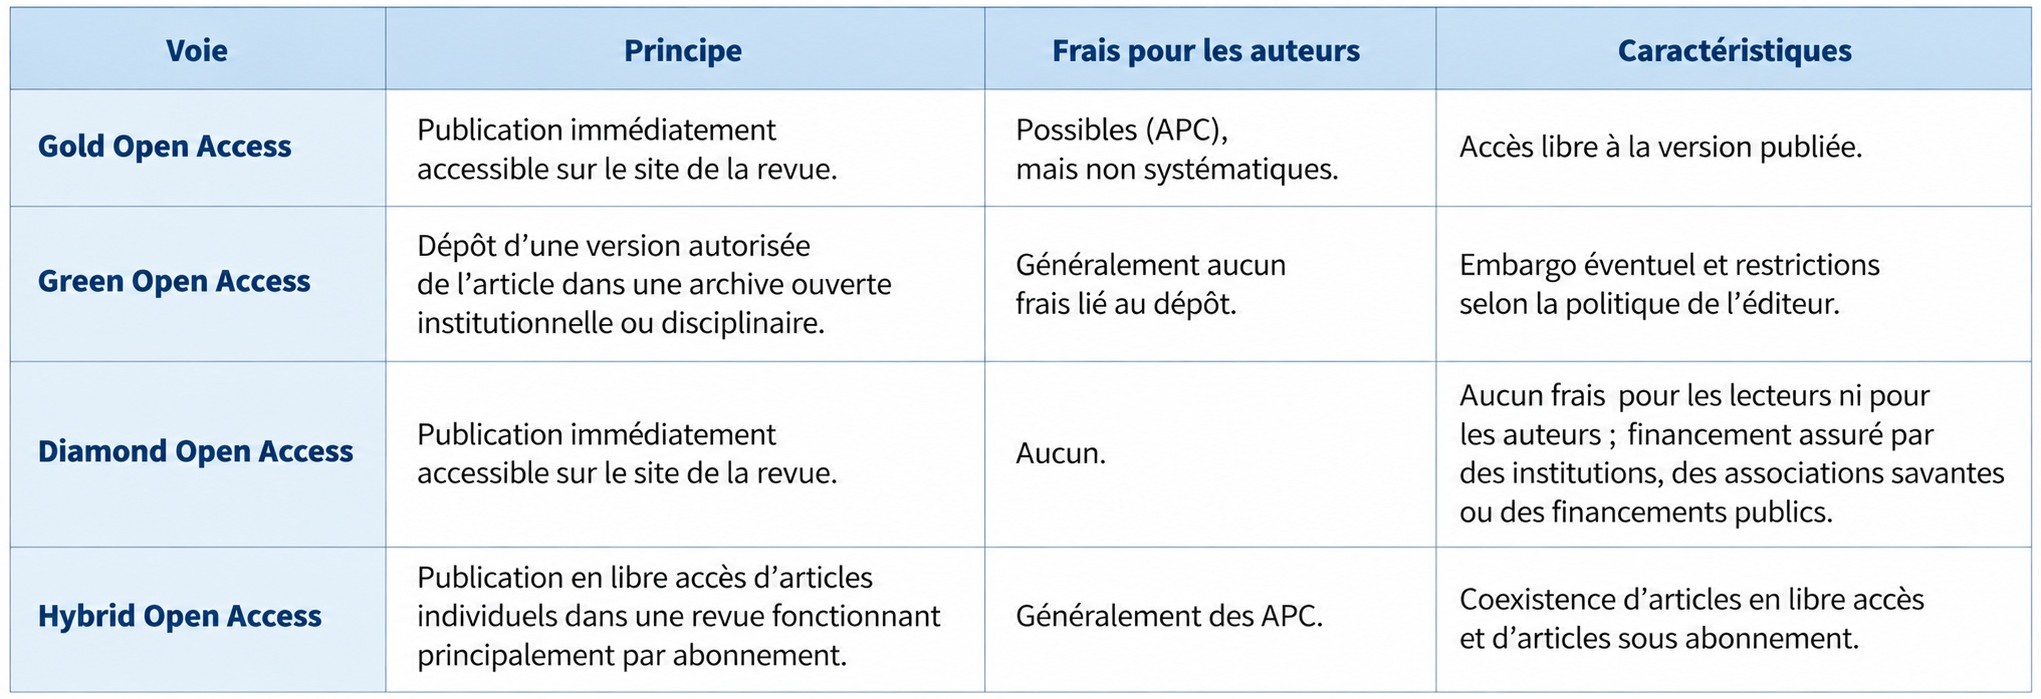
Comme vu ci-avant, le terme de libre accès désigne la mise à disposition en ligne des publications scientifiques sans barrière financière pour le lecteur. Plusieurs voies sont traditionnellement distinguées (tableau 6) :
- la voie Gold correspond à la publication directement accessible sur le site de la revue, avec ou sans frais de publication à la charge des auteurs (Article Processing Charges, APC) ;
- la voie Green repose sur le dépôt d’une version autorisée de l’article dans une archive ouverte, institutionnelle ou disciplinaire, éventuellement après une période d’embargo ;
- le modèle Diamond, parfois appelé Platinum, désigne des revues en libre accès ne facturant de frais ni aux lecteurs ni aux auteurs, généralement soutenues par des institutions publiques ou des sociétés savantes, mais pas toujours.
Ces catégories ne sont pas exclusives : une revue Diamond relève également de la voie Gold au sens de la diffusion immédiate par l’éditeur. Ces modalités de diffusion ne préjugent en rien des licences de réutilisation ; les restrictions imposées par certaines licences peuvent limiter sa conformité aux définitions les plus exigeantes du libre accès.
Carnets botaniques relève donc du modèle Diamond Open Access (absence de frais de publication pour les auteurs et accès gratuit pour les lecteurs). Les articles sont diffusés sous licence CC BY-NC-SA 4.0, qui autorise leur réutilisation non commerciale sous réserve d’attribution et de partage des adaptations dans les mêmes conditions (cf. § 9.3).
9.3. Les licences Creative Commons : un éventail de permissions
Les licences Creative Commons (CC) sont des normes internationales par lesquels un titulaire de droits peut accorder par avance certaines permissions au public, sous des conditions définies. Elles ne remplacent pas le droit d’auteur, mais s’appuient sur celui-ci. Elles ont été mises en place en 2001 sous l’impulsion de Lawrence Lessig, professeur de Droit américain à l’Université de Stanford (Lessing, 2004).
Concrètement, un éditeur de revue choisit de façon souveraine la licence adaptée à sa politique de diffusion et la mentionne sur ses publications, sans autre procédure.
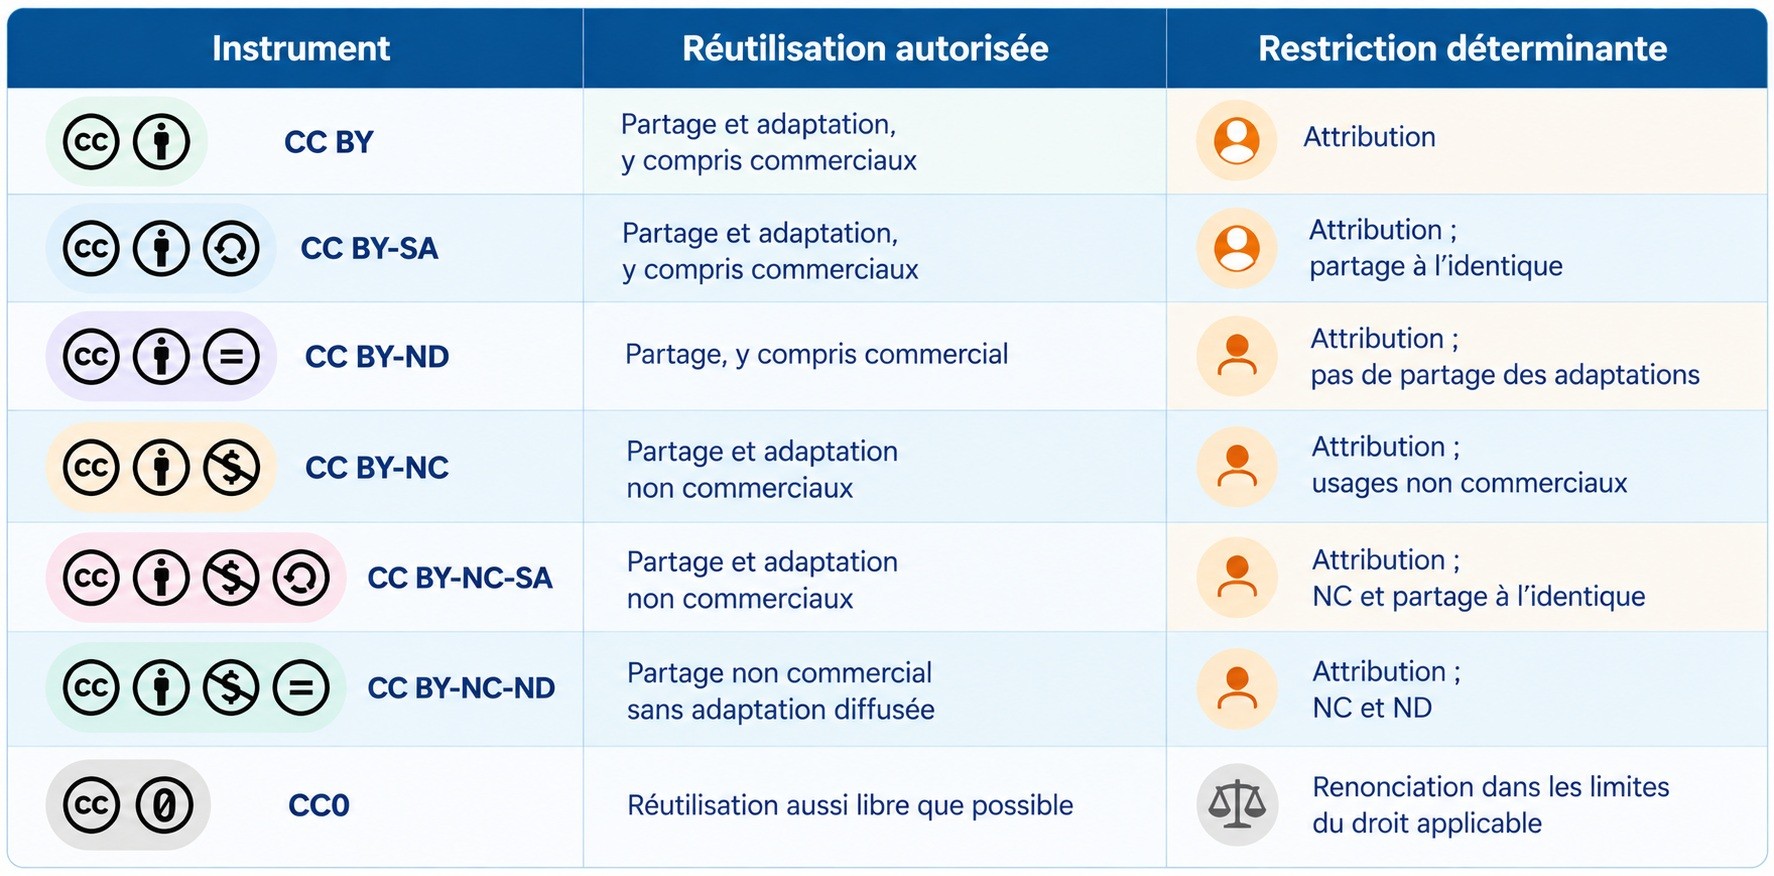
Une licence CC est la combinaison de plusieurs conditions : BY impose l’attribution, SA prévoit le partage des adaptations sous une licence identique ou compatible, NC limite les usages commerciaux et ND interdit le partage public d’adaptations, tout en permettant leur réalisation à titre privé, sous réserve des autres conditions de la licence.
Ces combinaisons produisent six licences principales (tableau 7). La licence CC0 relève quant à elle d’une logique différente : elle vise à renoncer aux droits dans la mesure permise par la loi et à accorder, à défaut, des permissions très larges (Creative Commons, s.d.).
La compatibilité avec les définitions exigeantes du libre accès ne doit pas être déduite du seul sigle CC : les clauses NC et ND restreignent certains usages. Pour les articles de recherche, CC BY est souvent privilégiée lorsque l’objectif est de permettre une large réutilisation avec attribution ; le choix concret relève toutefois de la politique éditoriale et des droits effectivement détenus par les auteurs ou l’éditeur (BOAI, 2002 ; Creative Commons, s.d.).
9.4. Les informations de licence dans les métadonnées Crossref
Crossref permet de déclarer des informations de licence à l’aide des métadonnées d’accès et de licence, notamment des éléments license_ref contenant l’URL des conditions applicables. La déclaration ne constitue pas, à elle seule, une validation juridique de la licence. Les services qui réutilisent les métadonnées peuvent exploiter ces informations pour signaler les droits et les conditions d’accès, sans que leur reprise soit automatique (Crossref, 2024).
Pour une revue indépendante, la bonne pratique consiste à afficher la licence de façon explicite et cohérente sur la page de chaque article et, si possible, dans le PDF, puis à reporter une URL de licence exacte dans les métadonnées déposées. Comme déjà évoqué, la licence ne doit pas être présumée à partir du caractère gratuit du site. Dans le cas de Carnets botaniques, la politique de droits réellement applicable aux articles a été établie avant de renseigner cette information dans Crossref.
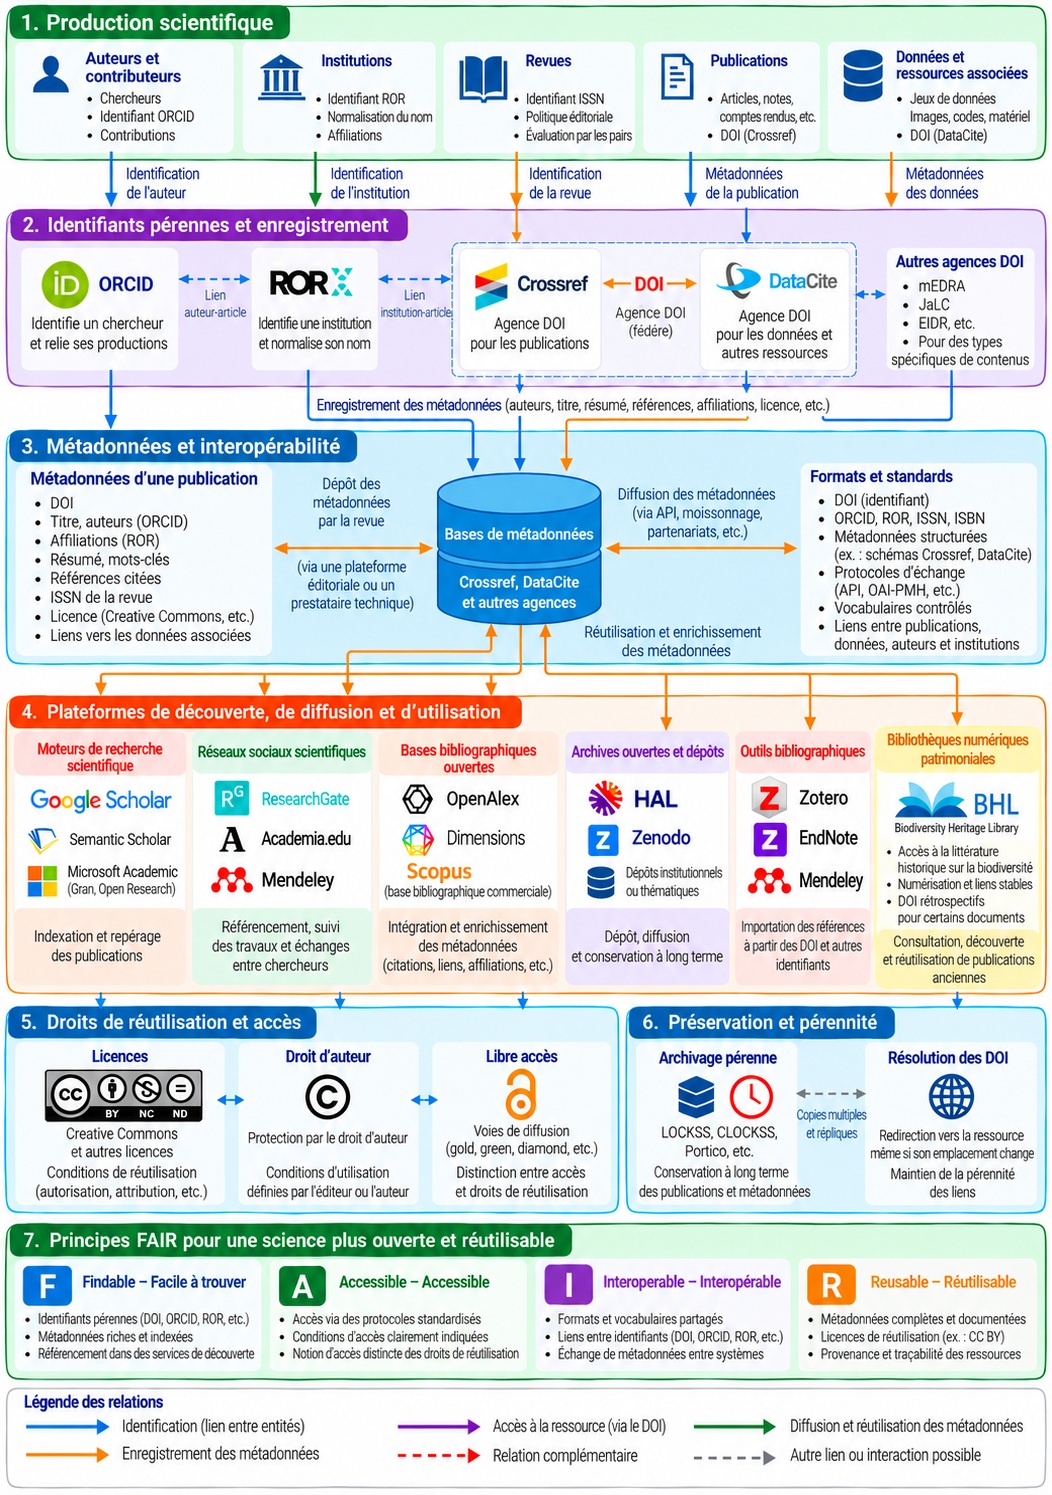
10. L’architecture documentaire : une vue d’ensemble
La figure 4 rassemble, sur une seule page, les acteurs évoqués dans cet article : identifiants des personnes (ORCID), des organisations (ROR), des revues (ISSN) et des objets scientifiques (DOI), agences qui enregistrent les DOI, plateformes qui rendent les travaux visibles et entités juridiques qui gouvernent leur réutilisation. Elle présente également les principales voies du libre accès (Open Access) : Gold, Green et Diamond.
Les flux représentés par les flèches ne sont pas des transferts obligatoires : Google Scholar, ResearchGate, OpenAlex ou Zotero possèdent des mécanismes de collecte différents et peuvent combiner plusieurs sources. Crossref ne « publie » pas les articles à leur place et Creative Commons ne « délivre » pas de DOI. Cette lecture en couches aide à comprendre l’apport de chaque dispositif sans confondre leurs missions respectives.
11. Recommandations pratiques pour les revues indépendantes
L’expérience de Carnets botaniques nous permet de proposer ici quelques recommandations à destination des revues scientifiques indépendantes portées par des entités de taille modeste, sans structure administrative conséquente. Intégrer l’architecture de l’édition numérique est généralement vécu comme un parcours du combattant complexe, jalonné de concepts et d’acronymes pas toujours explicites. Seule la rigueur et une méthodologie progressive permet de réaliser ces opérations sereinement. Ces recommandations concernent aussi bien les revues nouvellement créées que celles qui souhaitent moderniser une infrastructure existante ou changer d’agence d’enregistrement des DOI.
11.1. Mettre en place une infrastructure éditoriale numérique
La création d’une revue scientifique numérique commence par la publication de fichiers disponibles sur un site internet, mais ne se limite pas à cela. Elle implique aussi de définir son identité éditoriale, de mettre en place des procédures de publication lisibles et de disposer d’une infrastructure permettant l’identification, la citation et la consultation durable des articles.
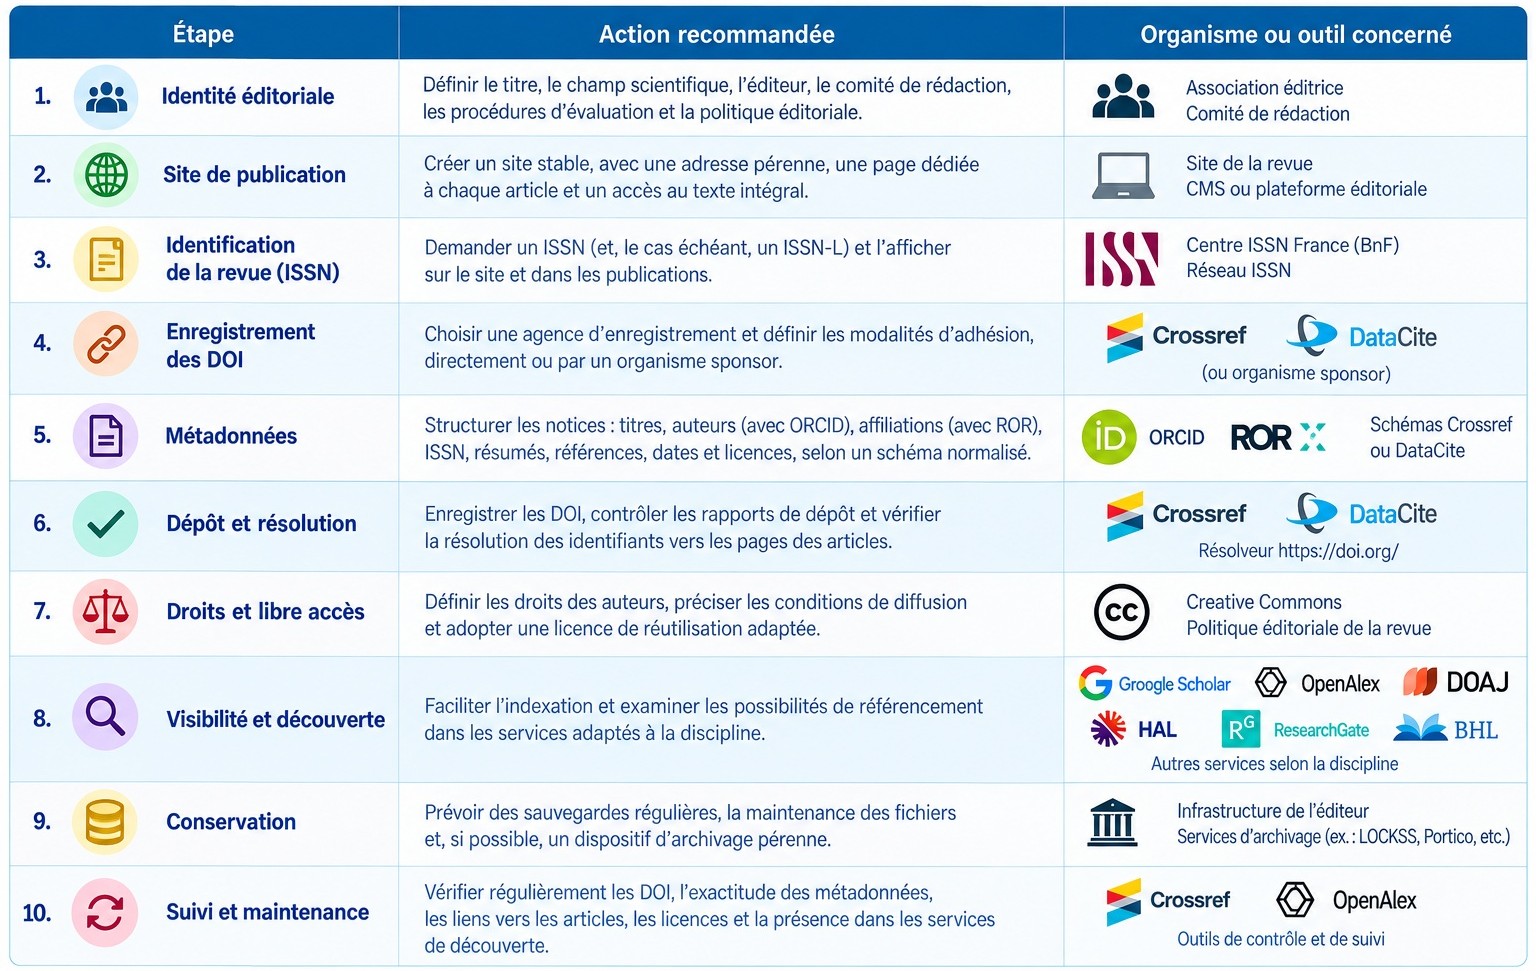
Une démarche chronologique peut être suivie, depuis la définition du projet éditorial jusqu’à la maintenance des publications. Elle comprend notamment, dans l’ordre, l’obtention d’un ISSN, puis le choix d’une agence d’enregistrement de ses DOI (avec la structuration des métadonnées correspondant à son cahier des charges), puis la définition des conditions juridiques de diffusion (choix des licences) et éventuellement la mise en œuvre de dispositifs favorisant la conservation des contenus. Le tableau 8 propose les principales étapes de cette démarche.
Si elles sont proposées ici dans un ordre donné, ces étapes ne constituent toutefois pas une succession rigide d’opérations. À l’exception de l’obtention de l’ISSN, qui semble la priorité n°1, certaines phases peuvent être conduites simultanément (par exemple choix d’agence, constitution du fichier XML et choix des licences CC). Leur mise en œuvre dépendra évidemment des ressources humaines, techniques et financières de la structure éditrice. Une possibilité est également de s’appuyer sur des organismes sponsor pour l’enregistrement de ses DOI, appelés Sponsoring Organization ou Crossref Sponsor. En France les plus importants sont OpenEdition et Métopes, mais il en existe de très nombreux. Au niveau mondial, les plus développés sont PKP (qui développe le logiciel Open Journal Systems : OJS), SciELO (Scientific electronic libray online), Lyrasis, etc. En fonction de leur statut, elles offrent des services gratuits ou payants.
Une attention particulière doit être accordée à la qualité des métadonnées dès les premières publications, notamment le DOI, l’identification des auteurs par ORCID, celle des organismes par ROR lorsqu’un identifiant existe, la mention de l’ISSN, la structuration des références bibliographiques et l’indication explicite des licences de réutilisation facilitent l’interopérabilité des notices et leur exploitation par les services documentaires.
11.2. Préparer et sécuriser un transfert de DOI entre agences d’enregistrement
Le transfert de DOI entre agences d’enregistrement est une opération assez exceptionnelle. Elle doit être préparé avec rigueur afin de garantir la conservation des identifiants historiques. L’expérience de Carnets botaniques montre qu’une telle migration peut être réalisée sans modifier les DOI existants.
Pour la résiliation pratique de cette opération, se reporter au §7.
11.3. Assurer la visibilité et la pérennité des publications
L’attribution de DOI ne garantit à elle seule ni la visibilité ni la conservation des publications. Une revue doit impérativement assurer la stabilité des pages de destination, actualiser ses métadonnées et vérifier périodiquement la présence et l’exactitude de ses notices dans les principaux services de découverte. La définition explicite des licences de réutilisation contribue également à l’interopérabilité et à l’application des principes FAIR.
La pérennité des contenus suppose par ailleurs des sauvegardes régulières et, lorsque cela est possible, le recours à des dispositifs d’archivage adaptés. Ces opérations doivent s’inscrire dans une politique de maintenance documentaire durable, proportionnée aux moyens de la structure éditrice.
11.4. Sécurité de l’hébergement d’un site et préservation à long terme des publications
La conservation durable des publications scientifiques est un enjeu majeur. Rien ne serait plus préjudiciable pour une revue que d’avoir mis en place l’ensemble des procédures ci-dessus évoquées et de perdre sa visibilité pour un problème de non-conservation de ses données pour des raisons techniques. Les articles doivent être matériellement conservés, intègres et accessibles dans la durée. Quatre niveaux de protection doivent être distingués :
- a) la sécurité de l’hébergement informatique,
- b) la sauvegarde et la restauration des données,
- c) la continuité de la diffusion
- d) l’archivage numérique pérenne.
a) La première exigence concerne la fiabilité de l’infrastructure hébergeant le site de la revue. Le recours à un prestataire spécialisé tel qu’OVHcloud (c’est le cas de Carnets botaniques), ou à une infrastructure institutionnelle disposant de garanties appropriées permet de limiter certains risques : défaillances matérielles, interruptions de service, cyberattaques. S’il ne s’agit pas d’une assurance absolue contre ces problèmes, ne pas faire appel à ces structures et faire le choix d’héberger soi-même son site serait s’exposer à des risques majeurs et irréversibles.
b) La réalisation de sauvegardes régulières est elle aussi indispensable. Dans l’idéal, elles doivent intégrer les fichiers PDF des articles, les illustrations, les bases de données, les métadonnées, les fichiers éditoriaux et les éléments nécessaires à la reconstruction du site. Plusieurs copies doivent être conservées, dont au moins une sur un support distinct du serveur principal. Les tests de restauration doivent également être faits. Les rôles respectifs de l’hébergeur, du webmaster et de l’éditeur doivent également être établis précisément dans une procédure.
c) La disponibilité du site internet constitue également un objectif majeur. Des interruptions temporaires sont acceptables, mais plusieurs évènements rares doivent être anticipés : la disparition définitive de la revue, la cessation d’activité de l’éditeur et l’obsolescence de l’infrastructure. Elles ne peuvent pas aboutir à l’indisponibilité définitive de la revue.
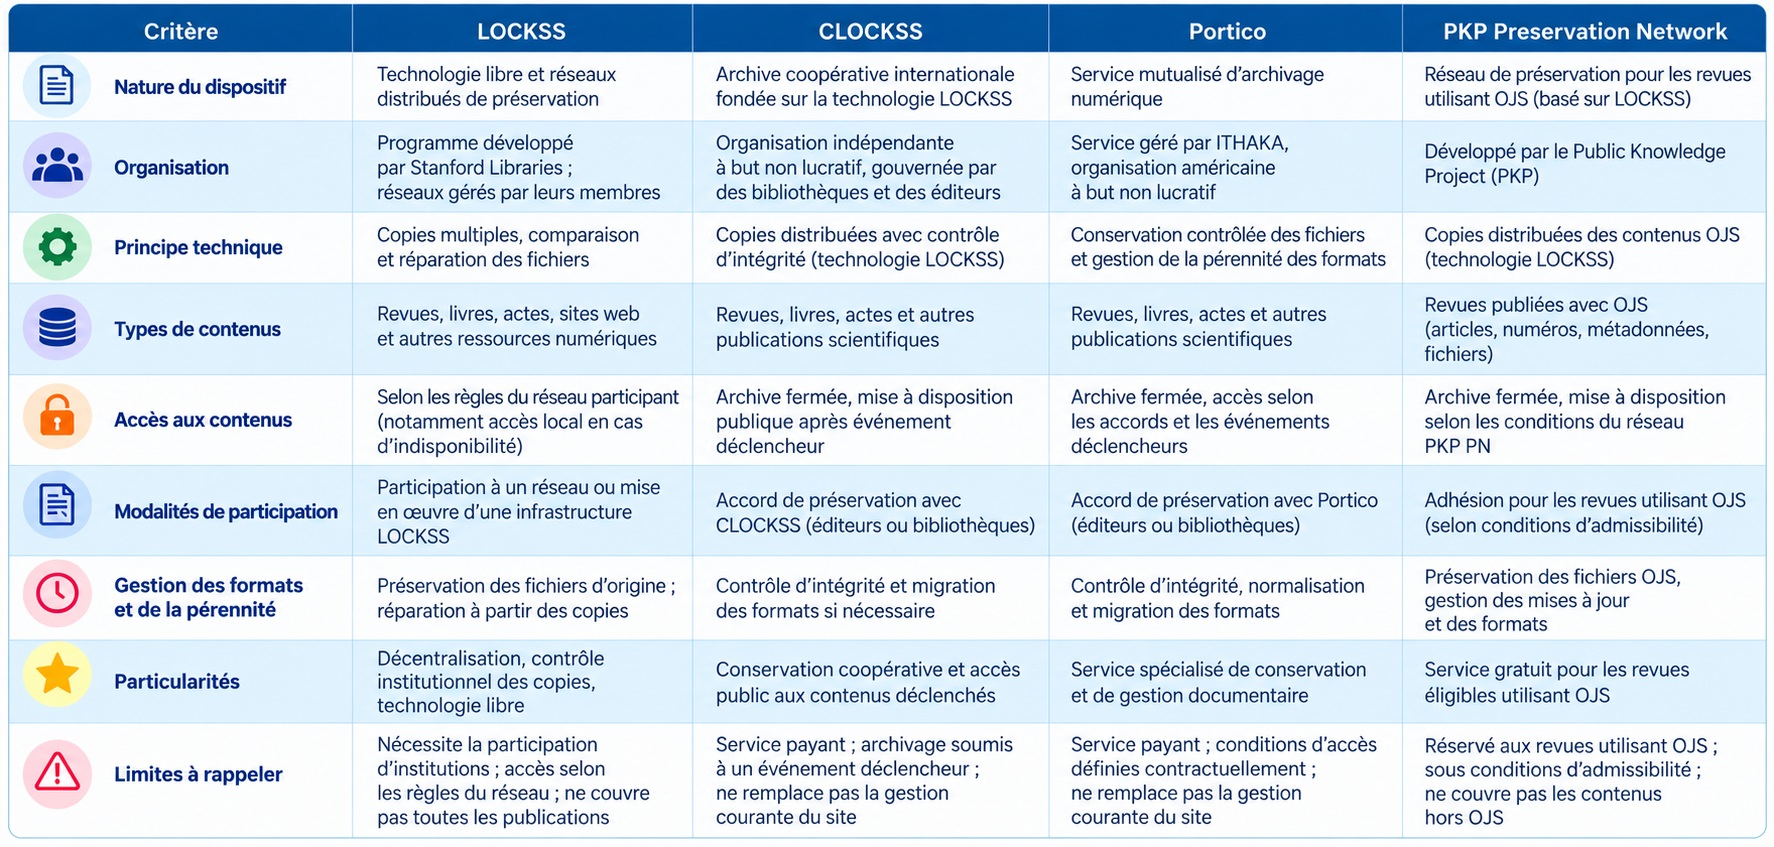
d) La préservation à long terme n’est pas une obligation mais est une sécurité importante, en particulier quand le volume des données devient important. Il nécessite de faire appel à des dispositifs spécifiquement conçus pour conserver les ressources scientifiques sur plusieurs décennies. Quatre d’entre eux sont à mettre en avant :
- Le programme LOCKSS (Lots of Copies Keep Stuff Safe), créé par l’université Stanford, est une organisation de plusieurs établissements conservant plusieurs copies des mêmes contenus numériques. La comparaison périodique de ces copies permet de détecter et corriger certaines altérations des fichiers (LOCKSS Program, s.d.).
- CLOCKSS (Controlled LOCKSS) utilise la technologie LOCKSS mais est élargi au niveau international, au niveau de bibliothèques et d’éditeurs scientifiques. Les contenus sont conservés dans ce vaste réseau et sont inaccessibles au public. Il vise notamment à garantir l’accès aux ressources scientifiques même lorsque leur éditeur n’est plus en mesure de les diffuser (CLOCKSS, s.d.).
- Portico est service de préservation numérique développé par ITHAKA, organisation à but non lucratif gérant notamment la bibliothèque numérique JSTOR ; il propose également une infrastructure mutualisée de conservation des publications électroniques, et contrôle leur intégrité et la gestion de leur pérennité technique (Portico, s.d.).
- Le PKP Preservation Network (PKP PN), développé par le Public Knowledge Project, est une autre possibilité, particulièrement adaptée aux petites revues scientifiques indépendantes. Fondé sur la technologie LOCKSS, ce réseau assure la conservation distribuée des contenus publiés au moyen du logiciel libre Open Journal Systems (cf. §. Son principal intérêt réside dans la gratuité du service pour les revues utilisant OJS (cf. §11.1). Il représente ainsi une solution particulièrement intéressante pour les revues disposant de moyens financiers limités (Public Knowledge Project, s.d.).
Les principales caractéristiques de ces trois dispositifs sont comparées dans le tableau 9.
12. Conclusion
L’architecture de l’édition scientifique numérique repose sur l’articulation de dispositifs aux fonctions distinctes :
- les identifiants pérennes permettent de reconnaître les objets, les personnes et les organismes ;
- les agences d’enregistrement maintiennent les notices DOI ;
- les métadonnées structurées favorisent la découverte et les échanges ;
- les plateformes rendent les travaux repérables ou accessibles selon leurs propres règles ;
- les licences précisent les conditions de réutilisation ;
- enfin, les stratégies d’archivage répondent à la question de la conservation.
Les principes FAIR offrent une grille de lecture transversale, mais aucun outil isolé ne suffit à les satisfaire.
Pour les revues indépendantes, l’enjeu ne se réduit pas à la possession d’un préfixe. Il consiste à mettre en place une chaîne de responsabilités durable, depuis la description des articles jusqu’à la maintenance des liens et à la conservation des contenus. La migration de Carnets botaniques illustre la possibilité de préserver intégralement les identifiants historiques tout en modifiant leur cadre d’enregistrement. Elle rappelle également qu’une opération réussie repose sur un travail documentaire et technique précis, souvent peu visible pour le lecteur final.
Déclaration relative à l’utilisation de l’intelligence artificielle
Les figures et tableaux présentés dans cet article ont été réalisés avec l’assistance de ChatGPT (OpenAI), sous la supervision de l’auteur, qui en a défini le contenu et conserve l’entière responsabilité scientifique.
Bibliographie
Bibliothèque nationale de France (BnF), s.d. Qu’est-ce que l’ISSN ? https://www.bnf.fr/fr/quest-ce-que-lissn [14/10/2026].
Biodiversity Heritage Library (BHL), s.d. About the Biodiversity Heritage Library. https://about.biodiversitylibrary.org/ [14/10/2026].
BOAI (Budapest Open Access Initiative), 2002. Read the Budapest Open Access Initiative, https://www.budapestopenaccessinitiative.org/read/ [14/10/2026].
Centre international de l’ISSN, s.d. Le réseau ISSN, https://www.issn.org/the-centre-and-the-network/our-organization/le-reseau-issn-en/?lang=en.
Cioffi A., Coppini S., Massari A., Moretti A., Peroni S., Santini C. & Asadi N.-S., 2022. Identifying and correcting invalid citations due to DOI errors in Crossref data. Scientometrics 127 : 3593-3612, https://doi.org/10.1007/s11192-022-04367-w.
CLOCKSS, s.d. How CLOCKSS Works. CLOCKSS Archive. https://clockss.org/about/how-clockss-works/ [21/10/2026].
Cousijn H., Braukmann R., Fenner M., Ferguson C., van Horik R., Lammey R., Meadows A. & Lambert S., 2021. Connected research: the potential of the PID Graph. Patterns 2 (1) : 100180, https://doi.org/
10.1016/j.patter.2020.100180.
Creative Commons, s.d. About CC Licenses, https://creativecommons.org/share-your-work/cclicenses/ [10/10/2026].
Crossref, 2020. REST API. Documentation officielle, https://www.crossref.org/documentation/retrieve-metadata/rest-api/ [10/10/2026].
Crossref, 2022. Transferring prefixes between different Registration Agencies, documentation technique, https://www.crossref.org/documentation/register-maintain-records/creating-and-managing-dois/prefix-transfers-other-ra/ [10/10/2026].
Crossref, 2024. License information, documentation technique relative aux licences et aux indicateurs d’accès (Access Indicators), https://www.crossref.org/documentation/schema-library/markup-guide-metadata-segments/license-information/ [13/10/2026].
Crossref, 2026. Metadata deposit schema 5.5.0, documentation technique. https://www.crossref.org/documentation/schema-library/metadata-deposit-schema-5-5-0/ [10/10/2026].
Dacos M., 2019. Des nains sur les épaules de géants : ouvrir la science en France. Revue Politique et Parlementaire. ⟨hal-02366604⟩.
DataCite Metadata Working Group, 2026. DataCite Metadata Schema, version 4.7, https://schema.datacite.org/ [10/10/2026].
DataCite, 2026. Prefix Transfers and Aliasing, documentation technique, https://support.datacite.org/docs/prefix-transfers-and-aliasing [10/10/2026].
Delgado-Quirós L. & Ortega J.L., 2024. Completeness degree of publication metadata in eight free-access scholarly databases. Quantitative Science Studies 5 (1) : 31-49, https://doi.org/10.1162/qss_a_00286.
DOI Foundation, s.d.-a. DOI Handbook, https://www.doi.org/doi-handbook/html/ [10/10/2026].
DOI Foundation, s.d.-b. Existing Registration Agencies, https://www.doi.org/the-community/existing-registration-agencies/ [10/10/2026].
DOI Foundation, s.d.-c. What Are Registration Agencies? https://www.doi.org/the-community/what-are-registration-agencies/ [10/10/2026].
GO FAIR Foundation, s.d. The FAIR guiding principles, https://www.go-fair.org/fair-principles/ [10/10/2026].
Hendricks G., Tkaczyk D., Lin J. & Feeney P., 2020. Crossref: the sustainable source of community-owned scholarly metadata. Quantitative Science Studies 1 (1) : 414-427, https://doi.org/10.1162/qss_a_00022.
International Organization for Standardization (ISO), 2022. Information et documentation. Numéro international normalisé des publications en série (ISSN). Norme ISO 3297:2022, https://www.iso.org/fr/standard/84536.html.
Jones S.M., Van de Sompel H., Shankar H., Klein M., Tobin R. & Grover C., 2016. Scholarly context adrift: three out of four URI references lead to changed content. PLOS ONE 11 (12) : e0167475, https://doi.org/10.1371/ journal.pone.0167475.
Kahn R. & Wilensky R., 2006. A framework for distributed digital object services. International Journal on Digital Libraries 6 : 115-123, https://doi.org/10.1007/s00799-005-0128-x.
Klein M., Van de Sompel H., Sanderson R., Shankar H., Balakireva L., Zhou K. & Tobin R., 2014. Scholarly context not found: one in five articles suffers from reference rot. PLOS ONE 9 (12) : e115253, https://doi.org/10.1371/
journal.pone.0115253.
Lessig L., 2004. The Creative Commons. Montana Law Review 65 (1) : 1-15.
LOCKSS Program, s.d. What is LOCKSS? Stanford University Libraries, Stanford. https://www.lockss.org/about/what-lockss [21/10/2026].
McMurry J., Juty N., Blomberg N., Burdett T., Conlin T., Conte N., Courtot M., Deck J., Dumontier M., Fellows D., Gonzalez-Beltran A., Gormanns P., Grethe J., Hastings J., Hériché J.-K., Hermjakob H., Ison J., Jimenez R., Jupp S., Kunze J., Laibe C., Le Novère N., Malone J., Martin M.-J., McEntyre J., Morris C., Muilu J., Müller W., Rocca-Serra P., Sansone S.-A., Sariyar M., Snoep J., Soiland-Reyes S., Stanford N., Swainston N., Washington N., Williams A., Wimalaratne S., Winfree L., Wolstencroft K., Goble C., Mungall C., Haendel M. & Parkinson H., 2017. Identifiers for the 21st century: how to design, provision, and reuse persistent identifiers to maximize utility and impact of life science data. PLOS Biology 15 (6) : e2001414, https://doi.org/10.1371/journal.pbio.2001414.
Meadows A., Haak L.L. & Brown J., 2019. Persistent identifiers: the building blocks of the research information infrastructure. Insights 32 : 9, https://doi.org/10.1629/uksg.457.
National Information Standards Organization (NISO), 2026. Journal Article Versions (JAV). NISO Recommended Practice RP-8-2026, https://doi.org/10.3789/niso-rp-8-2026.
OpenAlex, s.d. OpenAlex Help Center, https://docs.openalex.org/ [13/10/2026].
ORCID, s.d. À propos d’ORCID, https://info.orcid.org/what-is-orcid/ [13/10/2026].
Paskin N., 2002. Digital object identifiers. Information Services & Use 22 (2-3) : 97-112, https://doi.org/10.3233/ISU-2002-222-309.
Portico, s.d. – Our Work. Portico, ITHAKA. https://www.portico.org/our-work/ [21/10/2026].
Public Knowledge Project, s.d. – PKP Preservation Network. Public Knowledge Project. https://pkp.sfu.ca/pkp-pn/ [28/10/2026].
Research Organization Registry (ROR), s.d. About ROR, https://ror.org/about/ [13/10/2026].
ResearchGate, s.d. Help Center, https://help.researchgate.net/ [13/10/2026].
Shotton D., 2013. Publishing: Open citations. Nature 502 : 295-297, https://doi.org/10.1038/502295a.
Shotton D., Portwin K., Klyne G. & Miles A., 2009. Adventures in semantic publishing: exemplar semantic enhancements of a research article. PLOS Computational Biology 5 (4) : e1000361, https://doi.org/10.1371/journal.pcbi.1000361.
Wilkinson M.D., Dumontier M., Aalbersberg I.J., Appleton G., Axton M., Baak A., Blomberg N., Boiten J.-W., Bonino da Silva Santos L., Bourne P.E., Bouwman J., Brookes A.J., Clark T., Crosas M., Dillo I., Dumon O., Edmunds S., Evelo C.T., Finkers R., Gonzalez-Beltran A., Gray A.J.G., Groth P., Goble C., Grethe J.S., Heringa J., ’t Hoen P.A.C., Hooft R., Kuhn T., Kok R., Kok J., Lusher S.J., Martone M.E., Mons A., Packer A.L., Persson B., Rocca-Serra P., Roos M., van Schaik R., Sansone S.-A., Schultes E., Sengstag T., Slater T., Strawn G., Swertz M.A., Thompson M., van der Lei J., van Mulligen E., Velterop J., Waagmeester A., Wittenburg P., Wolstencroft K., Zhao J. & Mons B., 2016. The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3 : 160018, https://doi.org/10.1038/sdata.2016.18.
Remerciements
Je remercie Grégory Ravaz, webmaster de la Société botanique d’Occitanie, pour la préparation et la validation des fichiers XML et son rôle déterminant dans le réenregistrement des DOI historiques de Carnets botaniques. Je remercie également les équipes de Crossref, en particulier Collin Knopp-Schwyn et Lara Mattos, et de l’Inist-CNRS, notamment Julie Solviche, pour leur accompagnement.